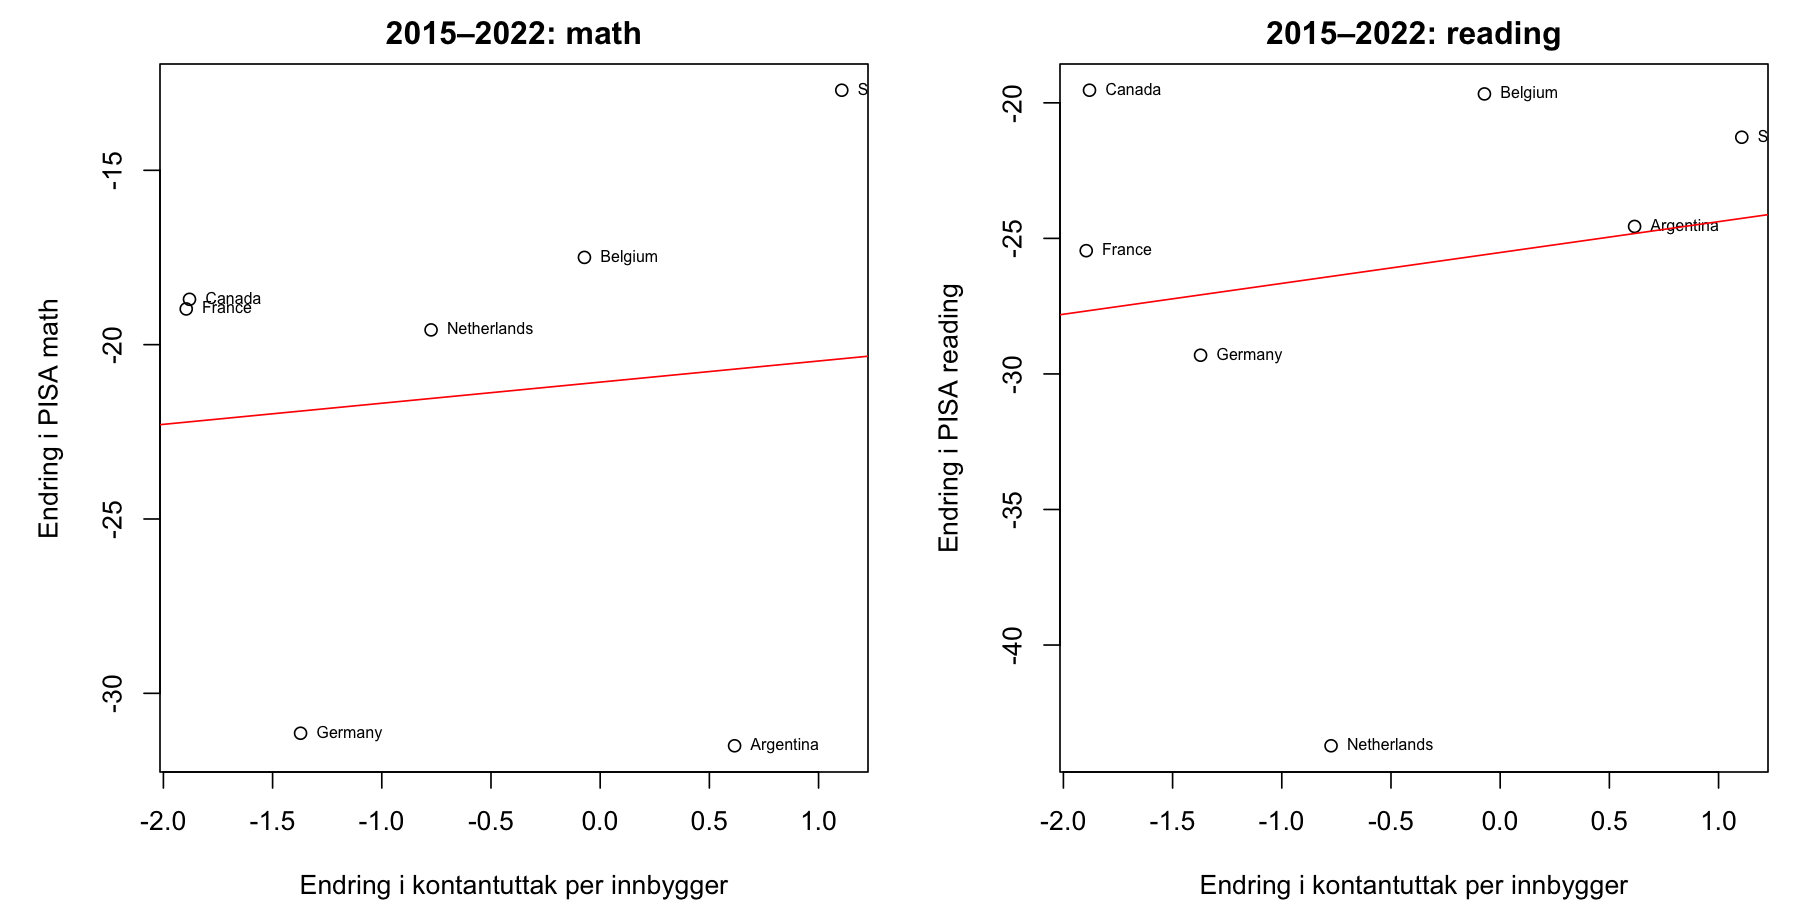
1 referanse-SD = 100 PISA-poeng. I grafen er 2015 nullpunkt for hvert fag.
Publiserte resultater
Lesing over tid
Referanse-SD · endring fra 2015Fire målinger, ulike elevkull
Se tallene bak grafen
Norske gjennomsnitt, avrundet til hele PISA-poeng
År
Lesing
Matematikk
Naturfag
Prøv en antakelse
Hvem mangler?
Scenario
10,4 % av elevene ble ekskludert i 2025. Hva om de hadde deltatt?
Én rute ≈ 1 % · oransje viser ekskluderte
Hvor mye lavere ville de ekskluderte skåret?
Samme nivå2,50 SD lavere
Endre eksklusjonsandelen
10,4 % er den oppgitte andelen for 2025. Andre verdier er hypotetiske.
Lesing · beregnet gjennomsnitt
442,6−10,4 poeng
Dette er en følsomhetsanalyse. Prestasjonene til de ekskluderte er ukjente.
Standardisert forskjell mellom elevkull
Cohen’s d · lesing, 2015–2025
Datagrunnlag mangler
Cohen’s d bruker spredningen i de to elevkullene. Rapporten oppgir standardavviket for 2025, men ikke et ferdig grunnlag for et samlet 2015–2025-estimat her. Derfor vises ingen ferdig beregnet norsk d-verdi.
Publisert poengforskjell−60 poeng
Forskjell / 100 poeng−0,60 referanse-SD
Cohen’s dIkke beregnet
Beregn d med egne verdier for valgt fag
Fyll inn standardavvik i PISA-poeng og antall elever som inngår i hvert fagestimat. Gjennomsnittene hentes fra fagvalget øverst. Verdiene du fyller inn er ikke kildeverifisert av siden, og lagres bare mens siden er åpen.
Fortegnet viser retningen: negativ d betyr lavere gjennomsnitt i 2025. Standardavvikene må beskrive elevprestasjonene, ikke standardfeilen til gjennomsnittet. Beregningen bruker de avrundede gjennomsnittene på siden.
Dette er en beskrivende standardisert forskjell, ikke en effekt av en bestemt undervisningsmetode. Større spredning kan gi mindre absolutt d selv ved samme poengfall. Vi bruker derfor ikke automatiske etiketter som «liten», «middels» og «stor».
PISA har et komplekst utvalg og flere plausible ferdighetsverdier. Et fullstendig estimat med konfidensintervall krever at dette håndteres i analysen. Kalkulatoren beregner ikke slik usikkerhet, og korrigerer ikke for eksklusjon. Den er uavhengig av eksklusjonsscenarioet ovenfor.
Velg fag og se resultater, endring siden 2015 og fordelingen på mestringsnivåer. «OECD-gjennomsnitt» er en referanserad, ikke et land.
Lesing i PISA 2025
Land
2025
Siden 2015
Forskjell fra Norge
Under nivå 2
Nivå 5 og 6
SD 2025
¹ Landet har økt utvalgsusikkerhet i PISA 2025. Gjennomsnitt og prosentandeler er avrundet som i den norske rapporten.
Sammensetning og følsomhet
Hva kan utvalget flytte?
Prøv hvordan endret gruppesammensetning og eksklusjon kunne påvirke forskjellen mellom to PISA-år. Kalkulatoren er et synlig regnestykke, ikke en korreksjon av de offisielle resultatene.
6,7 %
ekskludert i Norge i 2015
10,4 %
ekskludert i Norge i 2025
+3,7 pp
endring i eksklusjonsandel
Prøv en sammensetning
Velg fag og oppgi en hypotetisk gruppestørrelse og forskjell i gruppenes gjennomsnitt. Startverdiene 10 og 16,5 prosent er bare et regneeksempel; de er ikke påstått å være PISAs offisielle norske andeler. Dette er viktig, fordi en korrekt analyse må bruke de vektede, publiserte tallene for hvert år.
Her får den hypotetiske gruppen et lavere gjennomsnitt enn øvrige elever.
Legg til eksklusjon
Eksklusjon påvirker sammenligningen mellom år når andelen eller prestasjonsforskjellen endrer seg. Her holdes den antatte forskjellen mellom ekskluderte og deltakere lik i begge år. Tallene 6,7 og 10,4 prosent er de oppgitte norske eksklusjonsandelene.
Resultat av antakelsene
Publisert endring, lesing−60 poeng
Sammensetningens bidrag−5,2 poeng
Eksklusjonens bidrag−3,7 poeng
Gjenstående endring−51,1 poeng
Hva dette kan og ikke kan vise
Det du kan undersøke
Det du ikke kan slutte
Hvor stort matematisk utslag bestemte, uttalte antakelser gir.
At den samme effekten faktisk foreligger i de norske dataene.
At en endret andel på noen få prosentpoeng ofte får et begrenset utslag, med mindre gruppeforskjellen er svært stor.
At bakgrunn, hjemmespråk eller skole «forklarer» resten av utviklingen.
At økt eksklusjon kan gjøre et publisert fall for lite, dersom ekskluderte ville skåret svakere.
Hva de ekskluderte faktisk ville skåret; det er ikke observert.
Å «fjerne innvandrerskoler» er ikke en gyldig korreksjon. PISA er et vektet sannsynlighetsutvalg, og elevgrupper overlapper på blant annet hjemmebakgrunn, språk, botid og skole. En analysetilnærming må derfor beskrive det som en kontrafaktisk revekting – ikke som et nytt, «renset» nasjonalresultat.
Datagrenser og kilder
PISA publiserer bakgrunnsmål for innvandringsbakgrunn og språk hjemme, men «språk hjemme» er selvrapportering, ikke en norskprøve eller en måling av kognitive evner. Skolenavn og elevkoblinger er heller ikke et egnet offentlig datagrunnlag for å kartlegge «innvandrerskoler». Den norske PISA-rapporten og OECDs database er riktige startpunkter for en etterprøvbar analyse.
Resultatene gir grunn til uro, særlig i lesing og matematikk. De gir ikke en enkel årsaksforklaring, og heller ikke grunnlag for å dømme en hel ungdomsgenerasjon.
Hva som faktisk har endret seg
Fra 2015 til 2025 falt Norges gjennomsnitt med 60 poeng i lesing og 50 poeng i matematikk; naturfag falt 28 poeng. Når vi deler disse forskjellene på det observerte norske standardavviket i 2025, tilsvarer de omtrent −0,56, −0,52 og −0,27 standardavvik. Det er ikke Cohen’s d, fordi vi da også må ha sammenlignbar spredning for 2015. Likevel plasserer det størrelsesordenen: lesing og matematikk har beveget seg rundt et halvt elevkull-standardavvik nedover, naturfag klart mindre.
Det sterkeste varselsignalet ligger i fordelingen. Andelen under nivå 2 økte fra 15 til 34 prosent i lesing og fra 17 til 38 prosent i matematikk. Nivå 2 er PISAs operasjonelle grense for ferdigheter som anses nødvendige for å bruke fagstoffet videre; det er ikke en grense mellom «kan» og «kan ikke». Men når nær én av tre i lesing og nær to av fem i matematikk ligger under den, er det en stor gruppe som kan trenge mer systematisk oppfølging.
Norge er del av et større mønster
Dette er ikke en rent norsk historie. OECDs gjennomsnitt falt også betydelig fra 2015 til 2025, særlig i lesing og matematikk. Finland, Sverige, Danmark og Island har alle tilbakegang i minst ett av fagene. Det gjør en forklaring som bare handler om norsk skolepolitikk mindre overbevisende. Samtidig er Norges fall på 60 poeng i lesing og 50 i matematikk klart større enn den generelle OECD-utviklingen. At problemet finnes mange steder, gjør det ikke mindre presserende her hjemme.
De internasjonale dataene er derfor nyttige som korrektiv mot både selvpisking og selvtrøst. Norge er ikke alene om en negativ utvikling, men vi kan heller ikke forklare den bort som en internasjonal trend som treffer alle likt. OECDs internasjonale PISA-rapport og den tilhørende oppsummeringen gir det brede bakteppet.
Hva usikkerheten faktisk betyr
Utvalgsforbeholdet er reelt. Norge ekskluderte 10,4 prosent av målgruppen i 2025, mot 6,7 prosent i 2015. De ekskluderte kan godt ha prestert svakere enn deltakerne, slik at det publiserte gjennomsnittet blir for høyt. Det er imidlertid ikke kjent hvor svake de ville ha vært. Den norske rapporten bruker selv et følsomhetseksempel: Hvis de ekskluderte i gjennomsnitt ville skåret 100 poeng lavere, ville den økte eksklusjonen siden 2015 forklare omtrent fire poeng av forskjellen.
Det er nok til at sammenligningen må leses med større forsiktighet. Det er ikke nok til å underbygge påstanden om at en mye verre virkelighet er bevist, og enda mindre at det foreligger «metodisk juks». Eksklusjonsreglene er åpne, Norge er merket med økt utvalgsusikkerhet, og rapporten redegjør for mulige skjevheter. Spørsmålet er målekvalitet og generaliserbarhet, ikke en påvist skjult manipulasjon.
Motivasjon er en del av målingen
PISA har ingen konsekvenser for den enkelte elevs karakterer. I 2025 rapporterte færre norske elever høy innsats på prøven enn i 2018. Det kan trekke resultatene ned uten at samme nedgang gjelder all skolekompetanse. Rapporten drøfter denne muligheten ganske åpent. Samtidig peker den på nedgang i TIMSS, PIRLS og nasjonale prøver. Når flere uavhengige målinger går i samme retning, blir det mindre sannsynlig at hele endringen skyldes PISA-situasjonen alene.
Vi bør likevel ikke late som om testmotivasjon er et irritasjonsmoment som kan ignoreres. Den er en mulig del av det som har endret seg. Hvis ungdom er mindre villige til å holde ut konsentrert arbeid i en lavt belønnet prøvesituasjon, er det i seg selv et skole- og samfunnsrelevant funn, men det er ikke identisk med lavere kunnskap.
Hva resultatene ikke forklarer
PISA kan ikke avgjøre hvorfor endringen har skjedd. Fravær, svakere motivasjon, endrede lesevaner, digital distraksjon, pandemien, ulikhet og flere elever med behov for særskilt oppfølging kan alle være deler av bildet. Samvariasjon mellom skjermbruk og resultater kan gå begge veier og være påvirket av tredje faktorer. Det samme gjelder forskjeller mellom elevgrupper. En enkel forklaring på typen «nettbrettet gjorde det» eller «en bestemt pedagogikk ødela skolen» går langt forbi dataene.
PISA måler heller ikke intelligens. At gjennomsnittlige prestasjoner på denne typen oppgaver har gått ned, viser at bestemte anvendte ferdigheter og prøvesituasjonen har endret seg. Det sier ikke at norske femtenåringer er blitt mindre intelligente, og Flynn-effekten er uansett et annet spørsmål enn trenden i en internasjonal skoleprøve.
Er det krise?
Ordet er et politisk og moralsk valg, ikke en statistisk test. Jeg ville brukt det om situasjonen dersom det betyr at grunnleggende ferdigheter skal prioriteres høyere og følges opp med tiltak som faktisk blir evaluert. Jeg ville ikke brukt det som en dom over dagens ungdom, lærere eller foreldre. Resultatene begrunner bekymring og handling, men ikke panikk eller skråsikre forklaringer.
En fornuftig respons begynner med å se etter elevene bak gjennomsnittet: tidlig kartlegging av lese- og regnevansker, tilstrekkelig undervisningstid og oppmøte, tydelig og systematisk opplæring i grunnleggende ferdigheter, og ekstra støtte som undersøkes for om den virker. Slik blir PISA et startpunkt for bedre spørsmål, ikke et slagord som avgjør svaret på forhånd.
Her er gjennomgåelser av påstander, intervjuer og innlegg i sosiale medier om PISA. Hver tekst skiller mellom hva kildene faktisk dokumenterer og hvilke slutninger som går lenger enn datagrunnlaget.
Aftenposten · Tolv akademikere
Fagkunnskap må vises, ikke bare påberopes
Hvem bør styre skoledebatten? En grundig kommentar om ekspertise, foreldrestemmer, helseanalogien, skjermforskning, utforskende undervisning og hva PISA kan avgjøre.
Gode voksenferdigheter avlyser ikke dagens leseproblem
PIAAC nyanserer krisefortellingen, også med positive funn for unge voksne. Men hva kan voksenresultatene og evalueringen av fagfornyelsen egentlig si om dagens PISA-årskull?
Reformer må tåle kritikk – men hvem forklarer PISA-fallet?
En gjennomgang av påstandene om baseskoler, digitalisering, lærerautoritet og ekspertise. Hvor finnes konkret støtte, og hvor blir kritikken til en udokumentert årsaksforklaring?
En respons på to forslag til forklaring på PISA-resultater: digitale læremidler og mindre bruk av fysiske penger. De enkle landmønstrene gir ikke støtte til noen av hypotesene.
Hastige, feilaktige svar er et viktig spor. Men en enkel sammenheng mellom land kan ikke fortelle hvor stor del av PISA-fallet som skyldes lavere innsats.
PISA viser et problem, men velger ikke skolepolitikken
PISA underbygger at lesing og ulikhet må tas alvorlig. Den kan ikke alene avgjøre om styring, rapportering eller lærerautonomi er årsaken – eller løsningen.
Harry Potter og PISA: tidsrekkefølgen passer dårlig
Danmark holdt seg stabilt i lesing gjennom Harry Potter-bølgen. Fallet kommer først etter 2018, for kohorter som i økende grad vokste opp etter at bokserien var avsluttet.
God grunn til bekymring – men hva støtter løsningen?
PISA begrunner oppmerksomhet om leseferdigheter. Et skoleforlik, mer handlingsrom og bedre rammer må i tillegg vurderes etter hva de faktisk endrer for elevene.
Et rikt skoleliv og nyttige prøver kan høre sammen
En rimelig kritikk av å redusere skolen til tall blir til udokumenterte påstander om læring. Hva er egentlig problemet: prøven, tolkningen eller bruken?
Aftenposten · «Skal følelser eller fagkunnskap styre norsk skole?»
Fagkunnskap må vises, ikke bare påberopes
Tolv akademikere etterlyser en mer kunnskapsbasert skoledebatt. Det er et godt krav. Det bør også anvendes på deres eget innlegg: Hva dokumenterer de, hva vurderer de, og hvilke spørsmål har foreldre og elever selv rett til å reise?
Kort vurdering: Forfatterne har rett i at kjendisstatus, høy stemme og personlige erfaringer ikke dokumenterer hvilke tiltak som virker. De står svakere når de setter følelser opp mot fagkunnskap, foreslår fordelaktige lærererfaringer som motvekt til kritiske foreldrerfaringer, og lar bekymring for profesjonens omdømme gli over i spørsmål om hvem som bør få plass. En bedre debatt trenger relevant ekspertise, tydelig dokumentasjon og åpenhet for kritikk fra dem som lever med beslutningene.
Hva kommentaren bygger på
Grunnlaget er hele den oversendte teksten fra Aftenposten, publisert 21. september 2026, undertegnet av tolv akademikere, først Anne-Line Bjerknes. Kommentaren gjelder argumentene i innlegget. NRKs sending er ikke gjennomgått her; omtalen av taletid, tone og enkeltutsagn vurderes derfor som forfatternes gjengivelse, ikke som uavhengig kontrollerte observasjoner.
Innleggets avslutning er mer nyansert enn tittelen. Den gir plass til både forskning, faglige vurderinger og praksiserfaring. Forfatterne krever heller ikke uttrykkelig at foreldre skal tie. Den rimeligste lesningen er at de vil gi fagmiljøene større innflytelse og dempe en debatt der sterke enkelthistorier får for stor forklaringskraft. Det er dette argumentet som fortjener å bli prøvd.
1. Det beste argumentet deres er viktig
Det å ha gått på skole gir ikke automatisk innsikt i hvordan ulike elever lærer, hvordan en prøve er konstruert, eller hvordan man skiller reformeffekter fra samfunnsendringer. En gjenkjennelig historie kan være sann og samtidig lite representativ. Et forslag kan virke opplagt og likevel få uventede følger.
Derfor er det rimelig å etterlyse lærere med aktuell erfaring, forskere med relevant metodekompetanse og fagmiljøer som kan forklare kunnskapsgrunnlaget. Mediene har et ansvar for å gjøre mer enn å arrangere sammenstøt mellom personer med sterke meninger. Alle påstander fortjener ikke like stor faglig vekt bare fordi alle har rett til å ytre seg.
De nedsettende karakteristikkene av lærerstudenter som innlegget gjengir, er heller ingen analyse av opptakskrav eller utdanningskvalitet. Slike spørsmål trenger konkrete mål: Hvem tas opp, hva lærer de, hvilke krav stilles underveis, og hvordan utfører de yrket? Å omtale studenter som «amøber» opplyser ingen av delene.
2. Tittelen stiller opp et dårlig valg
Følelser og fagkunnskap er ikke to grupper mennesker. Foreldre kan ha lest forskningen. Forskere kan være opprørte, defensive eller overbevist på et svakt grunnlag. Det avgjørende er hva en påstand bygger på, ikke hvor følelsesmessig engasjert avsenderen er.
Det må dessuten skilles mellom en følelse som begrunnelse for en årsakspåstand og en følelse som informasjon om elevens situasjon. «Jeg liker ikke nettbrett, derfor lærer barn dårligere av dem» er et svakt argument. «Barnet mitt gruer seg, mister oversikten og får ikke hjelp» er relevant informasjon som skolen bør undersøke. Den kan være ufullstendig uten å være verdiløs.
Trivsel, trygghet og opplevd mestring er også mulige mål for skolen, ikke bare forstyrrelser i en diskusjon om testpoeng. Hvordan disse hensynene skal veies mot andre mål, kan ikke avgjøres av en effektstudie alene. Fagkunnskap kan belyse konsekvensene av valgene. Den kan ikke frita oss fra å velge.
3. Hvem har kunnskap om hva?
Relevant kompetanse er knyttet til spørsmålet
Spørsmål
Viktige bidrag
Typisk feilslutning
Hvordan oppleves skolehverdagen?
Elever, foreldre og ansatte, gjerne undersøkt systematisk.
At én erfaring beskriver alle skoler.
Hva gir bedre læring?
Egnet tiltaksforskning, fagdidaktikk og kunnskap om gjennomføring.
At en overbevisende demonstrasjon beviser effekt.
Hvorfor falt PISA-resultatene?
Målekompetanse, utvalgsmetode og troverdige årsaksanalyser.
At kjennetegn ved høytpresterende elever viser årsaken.
Hva skal skolen prioritere?
Demokratisk debatt, elevhensyn og kunnskap om konsekvensene.
At en tittel eller et flertall avgjør både fakta og verdier.
Hvordan kan tiltak gjennomføres?
Lærere, ledere, elever, foreldre og implementeringsforskning.
At gode intensjoner eller lokal tilslutning garanterer resultatet.
En naturfagdidaktiker kan ha svært relevant kompetanse om naturfagundervisning uten dermed å være spesialist på utvalgsvekter i PISA eller medienes effekt på lærerrekruttering. En psykometriker kan forstå prøven uten å kjenne et bestemt klasserom. En god debatt bruker disse forskjellene, fremfor å samle alle på hver sin side som «fagfolk» og «ikke-fagfolk».
Innlegget omtaler selv Sanna Sarromaa som historielektor. Det viser hvor lite ryddig motsetningen mellom medieprofil og fagperson kan bli. En person kan være begge deler, og et utsagn kan være dårlig begrunnet uansett hvilke meritter personen ellers har.
4. Helseanalogien har en viktig begrensning
Forfatterne spør hvordan det ville gått dersom de samme mediepersonene fikk definere medisinsk praksis. Analogien treffer én reell fare: Behandling bør ikke velges etter hvem som får mest oppmerksomhet. Men den gjør pasienter og pårørende for passive dersom den skal vise at erfaringer utenfra profesjonen mangler faglig betydning.
I Sackett og kollegers klassiske formulering av evidensbasert medisin (1996) inngår både forskningskunnskap og klinisk ekspertise, og anvendelsen må ta hensyn til pasientens situasjon og preferanser. Prinsippet er ikke at pasientens ønsker avgjør om en behandling virker. Det er at dokumentert effekt må vurderes sammen med forhold som ikke kan leses ut av et gjennomsnitt.
Overført til skolen betyr det at foreldres og elevers erfaringer skal undersøkes og inngå i vurderingen. Det betyr ikke at foreldrene får vetorett mot etablert kunnskap. Dessuten er skolepolitikk også spørsmål om felles kultur, prioriteringer og fordeling. Å møte en minister med en bekymring er ikke det samme som å overta det faglige ansvaret for undervisningen.
5. Foreldreinnflytelse er både nødvendig og problematisk
Foreldre har en legitim interesse i hva barna utsettes for, og elever har egne interesser som verken foreldre eller fagmiljøer alltid representerer fullt ut. Den som opplever en uheldig praksis, trenger ikke dokumentere en nasjonal årsak før skolen har grunn til å lytte.
Dette er også en del av skolens etablerte oppdrag. Overordnet del av læreplanverket fremhever foreldrenes kunnskap om barna, mulighet til innflytelse og skolens ansvar for samarbeid. Den minner samtidig om at elever har ulik tilgang til støtte hjemme.
Her ligger et sterkt argument i akademikernes favør: Mediemakt er skjevt fordelt. Ressurssterke, kjente foreldre kan få gjennomslag mens andre ikke blir hørt. Løsningen bør være bedre og bredere medvirkning, særlig fra elever og familier uten slik tilgang. Å overlate hele samtalen til profesjonenes talspersoner løser ikke automatisk representasjonsproblemet.
En forelder kan legitimt kreve at skolen undersøker distraksjoner. Forelderen kan ikke vedta at en dokumentert naturvitenskapelig sammenheng er usann. Demokrati gir rett til deltakelse og kontroll med beslutninger; det gjør ikke faktaspørsmål til avstemninger.
6. Fagmiljøenes erfaringer må prøves med samme målestokk
Innlegget etterlyser læreren som kan fortelle hvor gode digitale verktøy er til å differensiere undervisningen. En slik lærer kan vise muligheter, forklare bruken og oppdage problemer som andre overser. Men dersom positive enkelterfaringer skal svare på negative enkelterfaringer, har vi ikke dermed fått en effektstudie.
Spørsmålet bør stilles åpent: Når hjelper verktøyet, når hjelper det ikke, hvem faller utenfor, og hva sammenlignes det med? At et program gir ulike oppgaver til ulike elever, dokumenterer en funksjon. Om tilpasningen fører til bedre varig læring enn alternativet, er et annet spørsmål.
Det samme gjelder beskrivelsen av praktiske tiltak ved vitensentre. At fagmiljøer har arbeidet lenge og seriøst med et tiltak, gir grunn til å høre hva de har funnet. Det dokumenterer ikke alene tiltakets effekt eller hvor mye av det som finnes i en vanlig skoleuke. En henvisning til et miljø er en invitasjon til å undersøke kunnskapen, ikke en erstatning for å vise den.
7. Skjermforskningen gir argumenter til begge sider
Et konkret positivt eksempel er Muralidharan, Singh og Ganimian (2019). I et forsøk i India ble gratis tilgang til et tilpasset undervisningsprogram etter skoletid fordelt ved loddtrekning. De som fikk tilbudet, skåret etter omtrent fire og en halv måned 0,37 standardavvik høyere i matematikk og 0,23 høyere i hindi enn sammenligningsgruppen. Programmet kombinerte programvare med undervisningsstøtte i grupper, slik forskerne beskriver opplegget.
Det er et langt sterkere argument for mulighetene i tilpasset teknologi enn en begeistret brukerhistorie. Men forsøket isolerer ikke effekten av skjermen fra resten av tilbudet, og gir ingen garanti for samme resultat i norsk ordinær undervisning.
På den andre siden fant Delgado og kolleger (2018) en gjennomsnittlig fordel for papir ved lesing av sammenlignbare tekster. Forskjellen var omtrent 0,21 standardavvik, med tydeligere papirfordel under tidspress og for informasjonstekster enn for rent fortellende tekster. Dette gir et faglig grunnlag for deler av skjermkritikken. Det viser ikke at alle digitale arbeidsmåter er skadelige, eller at skjermbruk forklarer et bestemt antall tapte PISA-poeng.
Studiene gjelder ulike tiltak, sammenligninger og utfall. Effektstørrelsene kan derfor ikke trekkes fra hverandre for å beregne om «skjerm totalt sett» er bra eller dårlig. Digitale hjelpemidler, lesing av lange tekster, tilpasset øving og distraherende underholdning må vurderes hver for seg. Disse eksemplene illustrerer behovet for presisering; de er ikke en fullstendig oversikt over skjermforskningen.
8. Praktisk, utforskende og læringsfremmende er forskjellige egenskaper
Det er forståelig å etterlyse undervisning der elever bruker kunnskap og møter virkelige fenomener. Men «praktisk» kan bety alt fra et nøye planlagt eksperiment til en aktivitet der elevene bygger noe uten å forstå prinsippene. Aktivitetens synlige form forteller ikke alene hvor mye eleven lærer.
Her er Lazonder og Harmsens metaanalyse (2016) relevant. Den sammenfatter 72 studier og finner at veiledning i utforskende læring bedrer læringsutfallene, med en samlet effekt på d = 0,50 og et 95 prosent konfidensintervall fra 0,37 til 0,62. Dette tallet gjelder nytten av veiledning i de undersøkte oppleggene. Det er ikke en generell effekt av å erstatte eksplisitt undervisning med fri utforskning.
En faglig debatt bør derfor spørre hva elevene trenger av forkunnskaper, forklaringer og støtte, og hvordan utforskningen knyttes til det faglige innholdet. Teori og praktisk arbeid kan understøtte hverandre. At elever lærer om naturvitenskapelig utforskning, innebærer heller ikke at de selv må oppdage all kunnskapen de skal lære.
Innleggets formulering om at hindringen er ressurser og rammer, fremfor vilje, kan være riktig mange steder. Den er likevel for generell til å utelukke andre problemer. Læreplan, metodevalg, kompetanse, organisering og ressurser kan virke sammen. Gode intensjoner hos ansatte utelukker ikke svakheter ved praksisen; kritikk av praksis innebærer ikke nødvendigvis kritikk av intensjonene.
9. De beste PISA-elevene avslører ikke uten videre oppskriften
Forfatterne spør hva forskere kan fortelle om elevene som gjorde det best. Det er et relevant beskrivende spørsmål, men en risikabel vei til årsaksforklaringer. Flinke elever kan ha mer forkunnskap, bedre støtte og andre forutsetninger. Lærerne kan dessuten velge mer selvstendige arbeidsformer nettopp fordi elevene allerede mestrer stoffet.
Hvis høytpresterende elever bruker en bestemt arbeidsmåte, kan vi derfor ikke uten videre slutte at arbeidsmåten gjorde dem høytpresterende, eller at alle andre ville lære mer av den. Retningen kan være motsatt. En metode kan også fungere godt for elever med mye forkunnskap og dårlig for nybegynnere.
Dette er samme metodiske problem som ved enkle påstander om at lite testinnsats eller mye skjermbruk forklarer PISA-fallet. Beskrivende data kan gi hypoteser. Tiltakseffekter krever et design og en sammenligning som gjør alternative forklaringer mindre sannsynlige. Tolv akademikere kan med god grunn etterlyse denne presisjonen hos medieprofilene; de må også bruke den på egne forslag.
10. West Virginia: relevant fare, usikker overføring
Innlegget lenker til Sherfinski, Slocum og Loughs studie om pedagogikk i Appalachene, publisert på nett i 2020 og i tidsskriftårgangen 2022. Det tilgjengelige sammendraget beskriver en etnografisk kasusstudie av fem undervisningsmiljøer for små barn, med kullnæringens tilbakegang og overgang til naturgassutvinning som bakgrunn. Det er en annen type undersøkelse enn en kartlegging av amerikanske delstaters undervisningsregler.
Kildebegrensning: Hele forskningsartikkelen lot seg ikke kontrollere her. Den konkrete gjengivelsen av at foreldre hindrer undervisning om vannforurensning og klimaendringer, står derfor som en påstand i debattinnlegget som ikke er ferdig verifisert. Det ville være like uriktig å erklære den avkreftet som å behandle den som fullt kontrollert.
Selv dersom eksemplet er korrekt gjengitt, viser det ikke at norske foreldres skjermkritikk leder i samme retning. Økonomisk motivert press for å holde kunnskap unna barn og et krav om bedre begrunnelse for digitale læremidler er forskjellige handlinger. For å etablere analogien må forfatterne vise hva som faktisk er felles, og hvilke mekanismer som gjør utviklingen sammenlignbar.
Det holdbare prinsippet er at skolen må kunne formidle godt etablert kunnskap også når den er ubehagelig for foreldre eller lokale interesser. Det prinsippet er fullt forenlig med at foreldre får kritisere skolens metoder. Forskjellen mellom å undersøke undervisning og å sensurere innhold er avgjørende.
11. Påstanden om NRKs motiv trenger også belegg
At en sending oppleves høylytt og lite opplysende, kan begrunne kritikk av formatet. Det dokumenterer ikke i seg selv at redaksjonen satte sammen panelet for å skape mest mulig polarisering og høye seertall. Da går man fra en beskrivelse av sendingen til en påstand om hensikten bak.
Innlegget kunne stått sterkere med konkrete opplysninger om taletid, avbrytelser, faglige spørsmål som ikke ble fulgt opp, og hvilke relevante perspektiver som manglet. Skal man hevde at dette preger skoledebatten generelt, trenger man dessuten mer enn én sending. Forfatterne medgir selv at både forskere og politikere var til stede.
Dette fritar ikke NRK fra ansvar. En allmennkringkaster kan med rette kritiseres dersom formen gjør påstander vanskeligere å etterprøve. Men alternativet er ikke nødvendigvis et panel av bare akademikere. En god programleder kan la foreldre beskrive problemet, lærere forklare praksisen, forskere vurdere dokumentasjonen og politikere svare for beslutningene.
12. Rekruttering og yrkesstolthet er viktige – men avgjør ikke hva som er sant
Nedsettende omtale kan tenkes å gjøre læreryrket mindre attraktivt. Sammenhengen er plausibel, men innlegget viser ikke hvor stor betydning den har for søkertallene. Arbeidsbelastning, lønn, opptaksordninger, alternative utdanninger og forventninger til yrket kan også spille inn. Et fall i søkertall dokumenterer ikke virkningen av en bestemt debatt.
Det er rimelig å kreve at studenter og lærere omtales ordentlig. Men et mulig omdømmetap kan ikke være et generelt argument mot kritikk. Hvis en praksis er dårlig, blir den ikke bedre av at kritikken kan oppleves belastende. Profesjonell tillit kan også styrkes når feil erkjennes og rettes.
Forfatterne argumenterer selv med bekymring, yrkesstolthet og konsekvenser for fellesskapet. Det er legitime hensyn. Nettopp derfor blir tittelen om «følelser eller fagkunnskap» lite treffende: Deres egne verdihensyn må også kombineres med dokumentasjon, ikke presenteres som et alternativ til følelser.
13. Faglig autoritet må være relevant og åpen for kontroll
Det er for enkelt å svare at titler ikke betyr noe. De forteller noe om opplæring og erfaring, og en leser kan ikke etterprøve alle studier selv. Relevant ekspertise, forskningsoversikter og faglig enighet er gode grunner til å tillegge et råd vekt. Men vekten avhenger av spørsmålet og kunnskapsgrunnlaget.
En felles underskrift er heller ikke tolv uavhengige undersøkelser. Den viser tilslutning til teksten. Den dokumenterer ikke automatisk en faglig konsensus om årsakene til PISA-fallet, virkningen av digitalisering eller medienes innflytelse på rekruttering.
Akademiske miljøer kan ha faglige tradisjoner og institusjonelle interesser, akkurat som medieprofiler kan ha egne interesser. Dette er grunner til å ønske åpenhet, uavhengig evaluering og meningsbrytning. Det er ikke grunnlag for å tilskrive disse tolv bestemte motiver eller avvise forskningen deres på forhånd.
Å hevde at pedagogikk ikke er et fag, blir derfor like lite opplysende som å behandle alt som kommer fra pedagogiske miljøer som ferdig dokumentert kunnskap. Forskning på undervisning rommer ulike spørsmål og metoder. En god kvalitativ studie kan belyse erfaringer og gjennomføring; en god effektstudie kan undersøke utfallet av et tiltak. Kvaliteten ligger i samsvaret mellom spørsmål, metode og konklusjon.
14. Hva en mer kunnskapsbasert debatt faktisk ville kreve
Først må deltakerne formulere påstandene presist. «Skjermen ødelegger skolen» og «digitale verktøy er gode til differensiering» må oversettes til bestemte typer bruk, elevgrupper, alternativer og resultater. Deretter må både gunstige og ugunstige funn legges fram, sammen med begrensningene.
Så må man skille mellom tre oppgaver: å oppdage et problem, å forklare det og å velge tiltak. Foreldre kan oppdage et problem uten å ha rett om årsaken. Forskere kan kjenne en gjennomsnittseffekt uten å vite hvordan tiltaket skal fungere lokalt. Politikere kan legitimt prioritere mellom mål uten å kunne vedta at et tiltak har en effekt forskningen ikke viser.
Til slutt må det være mulig å korrigere praksis. Den som vil videreføre et omfattende tiltak, bør kunne begrunne det like konkret som den som vil innføre et nytt. Usikkerhet gir grunn til avgrenset utprøving og oppfølging; den gir ikke automatisk grunn til verken full omlegging eller uendret kurs.
Vår konklusjon: Innlegget er sterkest som kritikk av personangrep, lettvinte årsaksforklaringer og kjendisers uforholdsmessige innflytelse. Det er svakere som begrunnelse for at de foretrukne fagmiljøenes vurderinger bør få forrang uten at dokumentasjonen vises. Skoledebatten trenger faglig autoritet som tåler spørsmål. Det mest overbevisende svaret til en bekymret forelder er ikke bare hvem som vet best, men hva vi vet, hvordan vi vet det, og hva vi gjør dersom praksisen ikke hjelper eleven.
Gjennomgått 21. september 2026. Hele debattinnlegget er lest. Kommentaren bygger i tillegg på lenkede forskningsarbeider og læreplanverket. De utvalgte studiene illustrerer sentrale skiller, ikke en fullstendig forskningsoversikt. NRK-sendingen og hele Appalachene-studien er ikke kontrollert. Effektstørrelsene er hentet fra studiene og er ikke beregnet på PISA-data.
Reformer må tåle kritikk – men hvem forklarer PISA-fallet?
«Eksperter, be gone!» treffer et viktig spørsmål: Hvem tar ansvar når store skoleendringer svikter? Teksten er sterkere som krav om begrunnelse og etterprøving enn som dokumentasjon på hva som har forårsaket elevenes tilbakegang.
Kort vurdering: Goffeng har rimelige innvendinger mot reformiver, distraksjoner og beslutninger som overser klasserommet. Enkelte bekymringer har også konkret forskningsstøtte. Men PISA viser ikke at baseskoler, skolemiljøregler, administrasjon og digitalisering samlet forklarer nedgangen, eller at en retur til eldre skolepraksis er en dokumentert løsning. Kritikken blir mest treffsikker når den rettes mot bestemte råd, beslutninger og virkninger.
Les teksten som den sjangeren den er
Espen Goffengs Minerva-spalte ble publisert 16. september 2026. Hele teksten er lest i den oversendte PDF-en. Den er en satirisk, personlig utblåsning, ikke en forskningsrapport. Avslutningen om 1950-tallet og spanskrør skal derfor ikke behandles som et bokstavelig forslag om fysisk avstraffelse.
Likevel bygger satiren på påstander om virkeligheten: Eksperter skal ha fremmet skadelige endringer, foreldre skal ha forstått problemene før dem, og de dårlige resultatene skal vise følgene. Disse påstandene kan vurderes uten å kreve at en avisspalte skal ligne en vitenskapelig artikkel. Spørsmålet er om eksemplene bærer forklaringen de brukes til.
Goffeng skriver dessuten at både foreldre og eksterne forhold har bidratt, og takker eksperter som advarte. Han hevder altså ikke konsekvent at all ekspertise er verdiløs eller at skolen alene har skylden. Analysen må ta disse forbeholdene med.
Hva er dokumentert, plausibelt og uavklart?
Ulike påstander krever ulik dokumentasjon
Tema
Holdbar kjerne
Det teksten ikke viser
Baseskoler
Forstyrrende lyd kan gjøre det vanskeligere å oppfatte undervisning.
Hvor mye norske skolebygg bidrar til PISA-utviklingen.
Digitalisering
Mer utstyr garanterer ikke bedre læring. Bruken må begrunnes.
At alle digitale tiltak skader, eller hvor stor del av nedgangen de forklarer.
Autoritet og skolemiljøregler
Lærere trenger et tydelig handlingsrom og fungerende støtte.
At elevvern innebærer forbud mot saklig grensesetting, eller forklarer resultatfallet.
Administrasjon
Unødvendig rapportering kan fortrenge undervisningsarbeid.
Netto belastning, utvikling over tid og konsekvenser for læring.
Eksperter kontra foreldre
Praktiske erfaringer og varsler må tas alvorlig.
At foreldre generelt forutsier virkninger bedre enn relevante fagmiljøer.
1. PISA identifiserer ikke hvem som har skylden
Et fall i nasjonale elevresultater gir grunn til å undersøke skolepolitikken. Det identifiserer ikke effekten av en bestemt reform. Flere forhold endres samtidig: undervisning, elevsammensetning, oppvekstvilkår, fravær og testinnsats. Uten en egnet sammenligning kan vi ikke fordele poengfallet mellom dem.
Det er heller ikke nok å plassere en reform før en nedgang på en tidslinje. Vi må vite hvilke elever som faktisk var omfattet, når praksisen endret seg, og om mer eksponerte elever utviklet seg annerledes enn sammenlignbare elever. En nasjonal gjennomsnittskurve gir ikke den informasjonen alene. Internasjonale fellestrekk kan peke mot felles påvirkninger, men frikjenner heller ikke norske beslutninger.
Den første PISA-runden i 2000 kunne beskrive et nivå og forskjeller mellom land, men ikke en norsk PISA-trend fra før undersøkelsen startet. Når Goffeng knytter de første reformreaksjonene til negativ utvikling, må han derfor skille mellom skuffede forventninger til nivået og senere dokumenterte trender. Dette er en presisering av kronologien, ikke et argument for at senere nedgang er innbilt.
Samme krav gjelder alle sider i debatten. PISA beviser verken Goffengs reformforklaring eller Malkenes’ forklaring om styring. At de samme resultatene brukes til forskjellige politiske konklusjoner, viser hvorfor de mellomliggende årsaksleddene må undersøkes.
2. Baseskoler: bekymringen har et konkret faglig grunnlag
Støyproblemet bør ikke avfeies som foreldres motvilje mot forandring. Mealings og kolleger (2015) undersøkte taleoppfattelse blant fem–seksåringer i fire ulike undervisningsrom. Mer støy hang sammen med mindre presise og langsommere svar. Studien peker særlig på problemer med påtrengende lyd i helt åpne rom og behovet for egnet akustikk.
Studien gir støtte til en konkret mekanisme: Elever kan få vanskeligere tilgang til undervisningen når andre aktiviteter forstyrrer lyttingen. Den omfatter derimot små barn og fire rom, ikke norske 15-åringers langsiktige læringsutbytte. Den kan verken dømme alle åpne løsninger eller beregne deres bidrag til PISA-fallet.
Det er også forskjell på å bevise en nasjonal årsak og å begrunne en lokal utbedring. En skole trenger ikke vente på en landsdekkende effektstudie hvis observasjoner og lydmålinger viser at elevene ikke hører læreren. Klager, lærerobservasjoner og elevopplevelser kan være gode varsler. Den ansvarlige oppfølgingen er å undersøke forholdene og rette dem, ikke å kreve at foreldrene først forklarer hele den norske resultatkurven.
3. Digitalisering: manglende gevinst og skade er ulike funn
Goffeng har et sterkt prinsipielt poeng dersom utstyr ble innført i stor skala uten en klar pedagogisk begrunnelse. Den som vil endre undervisningen, bør forklare hva endringen skal forbedre, hva den erstatter og hvilke ulemper den kan gi. At teknologien er ny, er ingen slik begrunnelse.
Et relevant eksempel er Cristia og kollegers randomiserte studie (2017) av et datamaskinprogram ved 318 barneskoler på landsbygda i Peru. Etter 15 måneder hadde tilgangen og bruken økt, men forskerne fant ikke påvist effekt på språk- og matematikkprøver. De fant også enkelte, usikre tegn til bedre generelle kognitive ferdigheter. Studien viser hvorfor tilgang til utstyr ikke kan likestilles med faglig framgang.
Den dokumenterer ikke skade fra norsk digitalisering. Fravær av påvist gevinst er noe annet enn påvist negativ effekt; kontekst, alder, bruk og alternativ undervisning betyr noe. Distraherende mobilbruk, digital lesing, tilpassede øvingsprogrammer og hjelpemidler er heller ikke samme tiltak.
En politisk innrømmelse eller foreldres gjenkjennelse kan begrunne spørsmål om beslutningsprosessen, men er ikke en effektberegning. Den relevante undersøkelsen er hva slags digital bruk som fortrenger hva, for hvilke elever, og med hvilke resultater. Se også gjennomgåelsen av de enkle landhypotesene; manglende støtte i en slik sammenligning er heller ikke bevis for at alle lokale virkninger er null.
4. Elevvern er ikke det samme som fravær av lærerautoritet
Goffengs omtale av «paragraf 9a» trenger et skille mellom lovens innhold, hvordan skoler fortolker den, og hvordan lærere opplever håndhevingen. Et regelverk kan ha uheldige praktiske virkninger selv om formålet er godt. Men de virkningene må dokumenteres; de følger ikke automatisk av at eleven har rettigheter.
Udirs gjeldende veiledning om skolemiljøreglene viser til kapittel 12 i opplæringsloven. Den presiserer at elevens opplevelse ikke alene avgjør om en ansatt har opptrådt krenkende, og at irettesettelse og faglig uenighet ikke nødvendigvis er krenkelser. Skolen kan fortsatt ha plikt til å undersøke og hjelpe en elev som ikke har det trygt. At en melding må undersøkes, er ikke det samme som at læreren har gjort noe galt.
Denne presiseringen motbeviser ikke at tidligere regler, lokale tolkninger eller belastende saksbehandling kan ha svekket læreres trygghet. Den viser at «elevvern avskaffer autoritet» er for grovt som beskrivelse av dagens rettslige ramme. Vi trenger undersøkelser av hvordan konkrete krav påvirker praksis, støtte fra ledelsen, arbeidsbelastning og elevenes læringsmiljø.
Likeverd må dessuten skilles fra lik beslutningsmyndighet. Elever kan ha samme menneskeverd som lærere uten å ha samme ansvar for undervisningen. Tydelig ledelse, saklig grensesetting og vern mot ydmykelse er forenlige hensyn. Det interessante spørsmålet er hvordan skolen ivaretar dem samtidig.
5. Administrasjon: en rimelig hypotese, men anekdotene rekker kort
Det er fullt mulig at rapportering og utviklingsprosjekter tar tid fra planlegging, undervisning og oppfølging. Goffengs erfaringer fra universitetet og fortellinger fra helsetjenesten gjør problemet lett å kjenne igjen. De er likevel ikke undersøkelser av norsk grunnskole.
En vurdering må se på hvilke oppgaver lærerne faktisk utfører, hvor mye tid de tar, og hva administrasjonen samtidig avlaster dem for. Flere administrative ansatte kan gi flere krav, men kan også overta oppgaver som lærerne ellers måtte gjort. Antall ansatte avgjør derfor ikke nettoeffekten.
Det er også et ekstra sprang fra unødvendig arbeid til målbare utslag på elevenes ferdigheter. Vi kan begrunne fjerning av en rapport som ingen bruker, uten å hevde at den forklarer PISA-fallet. Omvendt bør dokumentasjon som beskytter elever eller gjør undervisningen bedre, ikke avskaffes bare fordi den er administrativ. Oppgavenes funksjon og kostnad er mer opplysende enn en generell karakteristikk av byråkratiet.
6. Hvem er «ekspertene», og hva visste de da?
Forskere, konsulenter, leverandører, byråkrater og politikere har forskjellige roller. En forsker kan advare uten å bli hørt; et vedtak kan markedsføres som forskningsbasert uten å følge kunnskapsgrunnlaget. For å plassere ansvar må vi vite hvem som anbefalte hva, hvilken dokumentasjon de brukte, hvem som bestemte, og hvordan kritiske tilbakemeldinger ble håndtert.
Dette er ikke en frikjennelse av fagfolk. Tvert imot gjør det kritikken etterprøvbar. En faglig anbefaling bør kunne vurderes ut fra det som var kjent da den ble gitt, hvor tydelig usikkerheten ble formidlet, og om rådene ble endret da nye funn kom. Dårlige råd bør ikke bli immune mot kritikk fordi avsenderen har en tittel.
Foreldres erfaringer er viktige, men Goffengs omgangskrets er ikke et representativt utvalg. I ettertid husker vi dessuten lettere advarsler som traff enn bekymringer som ikke slo til. Påstanden om at foreldre generelt lå foran fagmiljøene, krever derfor dokumenterte råd og varsler over tid. Tekstens egen takk til ekspertene som advarte, peker mot en mer presis konklusjon: Problemet kan være hvilke faglige stemmer beslutningstakerne lyttet til, ikke at fagkunnskap var unødvendig.
7. En gammel skolemodell er også en tiltakspakke
Gjentakelse, høytlesing, tydelige forventninger og arbeidsro kan hver for seg begrunnes og undersøkes. Men det følger ikke at alt som forbindes med en eldre skole, virker godt sammen eller passer alle alderstrinn. At en nyere løsning er svak, viser heller ikke at enhver eldre løsning er bedre.
Den samme vurderingen må gjelde begge veier: Hva skal eleven lære, hvordan hjelper aktiviteten, og hvordan ser vi om den virker? Kjedelighet er verken et kvalitetsstempel eller et bevis på dårlig undervisning. En oppgave kan være krevende og nyttig, eller ensformig uten nevneverdig læringsutbytte.
En saklig videreføring av Goffengs kritikk er derfor å prioritere faglig innhold, tydelig undervisning og læringsro der det er godt begrunnet, samtidig som man undersøker effektene. Det er ikke nødvendig å velge mellom moteriktig reformiver og en samlet gjeninnføring av fortidens skole. Se analysen av Hopfenbeck for skillet mellom støtte til konkrete undervisningsprinsipper og støtte til en hel skolemodell.
8. Den sterkeste konklusjonen: bedre begrunnede og korrigerbare beslutninger
Goffengs mest holdbare poeng er at kostnadene ved feil rammer elever, foreldre og lærere, mens ansvaret for beslutningen kan bli uklart. Store endringer bør derfor ha en konkret begrunnelse, en realistisk utprøving og en plan for å oppdage ulemper. Det bør være mulig å endre kurs uten at man først må forsvare reformens prestisje.
Ikke alle spørsmål krever et randomisert forsøk. Sammenligninger av skoler med ulik innføringstakt, gode målinger før og etter, observasjoner og systematisk innhenting av erfaringer kan bidra. Men man må forklare hva hver metode kan avklare. At lærere opplever mindre støy, og at elevenes leseferdigheter øker, er to forskjellige resultater som begge kan være viktige.
Vår konklusjon: Teksten er en berettiget utfordring til reformenes beslutnings- og ansvarskultur. Den dokumenterer ikke en samlet årsaksforklaring på PISA-fallet. Et bedre svar enn å avskaffe ekspertise er å kreve mer presise råd, åpenhet om usikkerhet, reell oppfølging av erfaringer og vilje til å korrigere dårlige beslutninger. Dette kravet gjelder også tiltakene kritikerne selv foretrekker.
En interessant motstemme er DN-innlegget om krisefortellinger. Goffeng advarer mot reformene som skader; DN-forfatterne mot reformreaksjonene som følger et sjokk. Begge bekymringene kan være relevante. Ingen av dem avgjør på egen hånd hva elevene lærer mest av.
Gjennomgått 19. september 2026. Grunnlag: hele Minerva-spalten, Udirs gjeldende veiledning og to avgrensede primærstudier. Studiene illustrerer hva konkrete undersøkelser kan belyse; dette er ikke en systematisk forskningsoversikt eller en ny beregning av reformenes effekt på norske PISA-resultater.
Dagens Næringsliv · Ann Elisabeth Gunnulfsen og Jeffrey B. Hall
Gode voksenferdigheter avlyser ikke dagens leseproblem
«Krisefortellinger og krisen som uteble» gir en nødvendig advarsel mot å gjøre PISA til en dom over hele skolen. Men voksenundersøkelsen og evalueringen av fagfornyelsen gir mindre grunnlag for beroligelse enn argumentasjonen kan gi inntrykk av.
Kort vurdering: Forfatterne har rett i at PISA verken måler hele skolens oppdrag eller avgjør framtiden til et årskull. Norske voksnes gode ferdigheter er et relevant korrektiv til undergangsfortellinger. De dokumenterer likevel ikke at dagens ferdighetsnedgang vil bli hentet inn, eller at bestemte arbeids- og styringsformer gir bedre læring. Det avgjørende skillet går mellom en overdreven krisefortelling og et reelt problem som krever oppfølging.
Hva hevder forfatterne egentlig?
Grunnlaget er innlegget i DN, publisert 16. september 2026, lest i sin helhet i den oversendte PDF-en. Gunnulfsen og Hall benekter ikke lesevanskene. De anerkjenner uttrykkelig både svake ferdigheter og bekymringsfulle forskjeller. En kritikk som fremstiller dem som om de hevder at alt er bra, ville derfor bomme.
Innlegget kobler tre argumenter: Offentligheten overdriver krisen; voksne har klart seg godt til tross for tidligere PISA-sjokk; forbedring krever langsiktig, lokalt profesjonsarbeid. Alle tre inneholder rimelige poenger. Det som må prøves, er overgangene mellom dem. Gode voksenresultater kan nyansere en samfunnsprognose uten å svekke dokumentasjonen av dagens elevresultater. Kunnskap om reformarbeid kan forklare gjennomføringsproblemer uten å vise hvilke undervisningstiltak som virker best.
Hvor langt rekker argumentene?
Funn, tolkning og manglende mellomledd
Argument
Dette holder
Dette følger ikke
PISA viser ikke hele skolen.
En vesentlig avgrensning av hva undersøkelsen måler.
At nedgangen i ferdighetene den måler, er uviktig eller uvirkelig.
Norske voksne gjør det godt i PIAAC.
Støttes av SSB, også med enkelte positive funn for unge voksne.
At de samme svake PISA-elevene er fulgt og har tatt igjen et etterslep.
Skoleansatte arbeider systematisk med utvikling.
Relevant kunnskap om praksis, kapasitet og gjennomføring.
At elevenes læringsutbytte er tilstrekkelig eller at reformen har positiv nettoeffekt.
Løsninger må utvikles lokalt.
Lokalkunnskap og tilpasning er nødvendige hensyn.
At nasjonale krav, støtte eller forskningsbaserte metoder derfor er feil.
Kriseretorikk kan skade tilliten.
En rimelig risiko å undersøke og ta hensyn til.
At svakere omtale av problemet i seg selv gir bedre læring.
1. En delmåling kan avdekke et alvorlig problem
Spørsmålet om PISA forteller hele sannheten, har et enkelt svar: Nei. Det er likevel ikke nødvendig å måle alt ved en institusjon for å oppdage en alvorlig svikt på ett område. Leseferdighet er dessuten relevant for mange av skolens øvrige mål, blant annet faglig selvstendighet og muligheten til å vurdere informasjon.
Udir oppgir et fall på 60 poeng i lesing fra 2015 til 2025 og en økning fra 15 til 34 prosent under nivå 2. OECD-gjennomsnittet falt også, men mindre. Dette er en utvikling i målte ferdigheter, ikke bare en lavere plassering på en internasjonal liste. Kilde: Udirs oppsummering.
Under nivå 2 betyr ikke analfabetisme, og en forskjell i testresultat er ikke automatisk et mål på skolens bidrag. Utvalg, testinnsats og sammenlignbarhet må vurderes. Men forbeholdene må knyttes til konkrete feilkilder og størrelser. At skolen også gjør mye verdifullt, er ikke i seg selv en alternativ forklaring på nedgangen.
Innlegget advarer med rette mot at én undersøkelse fortrenger annen kunnskap. Det viser derimot ikke systematisk hvor ofte dette skjer i mediene, eller hvilken relevant forskning som faktisk blir utelatt. Påstanden om debattens slagside er derfor også en vurdering, ikke et dokumentert resultat av en medieanalyse.
2. PIAAC gir en reell nyansering – også for unge voksne
SSBs rapport om PIAAC 2023 bekrefter et høyt norsk ferdighetsnivå sammenlignet med andre deltakerland. Leseforståelsen var stabilt høy fra 2012 til 2023, mens tallforståelsen ble bedre. SSB finner dessuten bedre leseforståelse blant 20–24-åringer i 2023 enn blant samme aldersgruppe i 2012, og bedre tallforståelse i aldersgruppene mellom 16 og 29 år.
Det ville dermed være for enkelt å avfeie DN-innlegget med at gode eldre årskull skjuler svake unge. Positive funn finnes også blant unge voksne. Dette er en reell grunn til å være varsom med påstanden om at ungdomsresultater nødvendigvis innebærer en framtidig, generell kompetansekollaps.
Men heller ikke voksenbildet er problemfritt. SSB oppgir at rundt 15 prosent av voksne har svake leseferdigheter. Et høyt nasjonalt gjennomsnitt og en utsatt minoritet kan eksistere samtidig. Dessuten gjelder framgangen sammenligninger av aldersgrupper ved to tidspunkt; det er ikke de samme personenes utvikling som rapporteres.
3. Hvilke årskull snakker vi om?
Her ligger innleggets viktigste metodiske sprang. Formuleringen om hvordan det gikk med elevene etter 2001 inviterer til å lese PIAAC som en oppfølging av tidligere PISA-deltakere. Det er ikke hva den vanlige sammenligningen mellom undersøkelsene er. PIAAC bygger på et eget utvalg av voksne. Den norske datainnsamlingen foregikk i 2022–2023. Kilde: SSBs metodebeskrivelse.
Omtrentlig alder i 2023, beregnet fra alder 15 i PISA-året
PISA-årskull
Alder i 2023
Hva innebærer det?
2000
Omtrent 38 år
Kan være representert i voksenutvalget, men ble ikke fulgt som den opprinnelige PISA-gruppen.
2015
Omtrent 23 år
Ligger nær en aldersgruppe med positive PIAAC-funn; dette er relevant, men ikke en individuell oppfølging.
2025
Omtrent 13 år
Var for unge til å inngå i voksenundersøkelsen.
Aldrene er illustrative; fødselsdato og undersøkelsestidspunkt gir noe variasjon. Den logiske begrensningen er likevel klar: En voksenmåling fra 2022–2023 kan ikke vise hvordan dagens PISA-årskull vil klare seg som voksne.
En sammenligning av de samme fødselskullene i ulike undersøkelser kan være opplysende, selv uten å følge enkeltpersoner. Men den krever egne analyser av sammenlignbare grupper, inn- og utvandring, frafall og målemetoder. PISA- og PIAAC-poeng er heller ikke direkte omregnbare. En høyere rangering i voksenundersøkelsen er ikke et mål på hvor mye norske elever har lært etter 15-årsalderen.
4. At en katastrofe uteble, avgjør ikke om advarselen var feil
Et varsel om risiko er ikke nødvendigvis en spådom om et uunngåelig utfall. Hvis en advarsel fører til bedre opplæring eller mer støtte, kan utfallet bli bedre nettopp fordi noen handlet. Den muligheten er nok til å vise hvorfor «det gikk bra senere» ikke alene avgjør om den opprinnelige bekymringen var grunnløs.
Det motsatte gjelder også: Vi kan ikke gi reformene etter 2001 æren for gode voksenresultater uten å undersøke effektene deres. Videre utdanning, arbeidsliv, befolkningssammensetning og andre endringer kan ha bidratt. Begge fortellingene trenger et troverdig sammenligningsgrunnlag: Hvordan ville utviklingen vært uten tiltakene?
For å etterprøve at en varslet krise uteble, må man først identifisere hva som faktisk ble varslet, av hvem og for hvilken periode. Samfunnskollaps, svakere gjennomsnittlige ferdigheter og større problemer for enkelte grupper er forskjellige påstander. DN-innlegget angir ingen presis historisk prognose som kan testes. Det svekker den bastante tittelen mer enn den forsiktige hovedteksten.
5. Godt reformarbeid er ikke det samme som dokumentert læringseffekt
Forfatterne har et relevant faglig poeng: Politiske vedtak blir ikke automatisk til god undervisning. Studier av hvordan lærere tolker og gjennomfører reformer, kan vise hindringer som en resultatmåling ikke fanger opp. Slik forskning er nødvendig for å forstå hvorfor et tiltak lykkes noen steder og mislykkes andre.
Men innsats, gjennomføring og resultat må skilles. En skole kan ha samvittighetsfulle lærere og grundige utviklingsprosesser samtidig som mange elever ikke lærer nok. Det kan skyldes rammer, uegnet innhold, svak gjennomføring eller vanskeligere elevforutsetninger. Observasjoner av profesjonelt arbeid kan motsi en karikatur av late eller likegyldige lærere. De motsier ikke i seg selv en nedgang i elevferdigheter.
Udirs omtale av sluttrapporten fra EVA2020 gir dessuten et mer sammensatt bilde enn bare vellykket utviklingsarbeid. Den beskriver både positive erfaringer med handlingsrom og usikkerhet om tolkningen av læreplanen. Omtalen reiser spørsmål om tydelig innhold og progresjon, og peker på behov for støtte, styring og struktur. Rapporten anbefaler også tid til langsiktig arbeid før en eventuell ny reform.
Dette støtter kritikken av stadige omlegginger, men gir ikke et enkelt argument mot styring. Den aktuelle omtalen dokumenterer heller ikke at LK20 har forbedret nasjonale leseferdigheter sammenlignet med hva som ellers ville skjedd. Her vurderes hva de omtalte funnene kan underbygge; det hevdes ikke at hele evalueringsprogrammet bare undersøker prosesser.
6. Tillit og etterprøving kan styrke hverandre
Det er god grunn til å beskytte lærernes arbeidsro mot kortvarige politiske utspill. Men prinsippet om at løsningene må utvikles nedenfra, er ikke en universell effektlov. Lokale miljøer trenger tilgang til kunnskap, læremidler, tid og tydelige forventninger. Felles krav kan også beskytte elever mot at kvaliteten avhenger for mye av hvilken skole de tilfeldigvis går på.
Spørsmålet er derfor hvilken kombinasjon som fungerer: Hva bør være felles, hva bør læreren tilpasse, og hvordan oppdager man når elever ikke får tilstrekkelig hjelp? Tillit er forenlig med at metoder må begrunnes og resultater undersøkes. Etterprøving trenger ikke innebære rangering, mistenkeliggjøring eller omfattende rapportering.
Forfatternes bekymring for at kriseretorikk kan undergrave tilliten, er rimelig. Men om den faktisk gjør det, og med hvilke konsekvenser for læringen, må undersøkes. Skolens omdømme kan ikke alene avgjøre hvor tydelig et dokumentert problem skal omtales. Saklig kritikk av rammer og praksis er heller ikke det samme som mistillit til lærernes motiver.
7. Hva bør vi gjøre med denne kunnskapen?
En forsvarlig oppfølging har to tidsperspektiver. Elever som nå strever med lesing, trenger konkret kartlegging og egnet undervisning. Det kan ikke vente på at hele samfunnsutviklingen er forklart. Samtidig bør omfattende reformer begrunnes med mer enn at PISA-kurven peker nedover, og vurderes med både læringsutbytte, belastning og skolens øvrige mål for øye.
For å prøve DN-innleggets sterkeste hypotese om senere innhenting trenger vi sammenlignbare analyser av fødselskull og helst oppfølging fra ungdom til voksenliv. For å prøve styringsforslagene trenger vi mer presise tiltak og evalueringer av hva de endrer for elevene. Profesjonenes erfaringer hjelper oss å forstå gjennomføringen; ferdighetsmålinger hjelper oss å undersøke resultatene. Ingen av delene erstatter den andre.
Vår konklusjon: Innlegget er overbevisende som kritikk av sikre undergangsprognoser og raske reformreaksjoner. Det er mindre overbevisende som dokumentasjon på at den varslede krisen var ubegrunnet, eller som begrunnelse for én bestemt styringsmodell. Norske voksnes gode resultater gir håp og nyttige spørsmål. De fritar oss ikke fra å hjelpe dagens elever.
Gjennomgått 19. september 2026. Grunnlag: hele DN-innlegget, SSBs publiserte PIAAC-resultater og metodebeskrivelse, samt Udirs oppsummeringer av PISA og EVA2020. Alderseksemplene er enkle beregninger, ikke en kobling av persondata. Ingen ny analyse av mikrodata eller fullstendig evaluering av fagfornyelsen er gjennomført.
Bedre leseopplæring og kartlegging – hva viser England?
Hopfenbeck peker på konkrete undervisningsprinsipper som fortjener oppmerksomhet. Begrunnelsen er sterkest der den bygger på forskning på læring, og svakere der forskjeller mellom land blir forklaringer på hvilke reformer som virker.
Kort vurdering: Systematisk leseopplæring og kartlegging med oppfølging har et selvstendig kunnskapsgrunnlag. PISA kan begrunne at vi undersøker disse tiltakene nærmere, men dokumenterer ikke at mer testing eller hele den engelske skolemodellen er løsningen på Norges nedgang.
Hva vurderes her?
Grunnlaget er Kristine Sørheims intervju med Therese Hopfenbeck i Morgenbladet, publisert 15. september 2026. Hele intervjuet er lest i en oversendt PDF. Dette er en vurdering av argumentene slik de fremkommer der, ikke av alt Hopfenbeck har skrevet eller forsket på.
Intervjuet inneholder et vesentlig forbehold: Hopfenbeck advarer mot én enkelt årsaksforklaring og anerkjenner verdier ved norsk skole. Hun anbefaler ikke ukritisk kopiering av England. Likevel kan leseren sitte igjen med en kjede fra bedre engelske resultater, via leseopplæring og testing, til bestemte norske tiltak. Hvert ledd trenger sin egen begrunnelse.
Påstandene har ulik støtte
Skillet mellom undervisningsforskning og landforklaringer
Påstand
Vurdering
Begrensning
Systematisk arbeid med bokstaver og språklyder hjelper.
Har støtte i forskning på tidlig lesing.
Avkoding er ikke hele leseforståelsen.
Kartlegging kan avdekke behov for hjelp.
Et godt begrunnet formål.
Nytten avhenger av kvalitet, tiltak og oppfølging.
England viser hva som virker.
Gir relevante hypoteser.
Landforskjeller isolerer ikke effekten av bestemte tiltak.
Wales’ pedagogiske kurs forklarer nedgangen.
For lite konkret som årsaksforklaring.
Reformer, tidspunkt og hvilke elever de omfatter må avklares.
Bedre prestasjoner krever et valg mellom topp og bredde.
Prioriteringer er nødvendige.
Grunnferdigheter kan også styrke inkludering og de svakeste elevene.
Leseopplæringen trenger ikke PISA for å begrunnes
EEFs forskningsoversikt om bokstav–lyd-opplæring støtter eksplisitt og systematisk undervisning i tidlig lesing. Den understreker samtidig at økt avkodingsnøyaktighet ikke nødvendigvis gir bedre forståelse, og at ordforråd og forståelse også må utvikles. Denne avgrensningen er viktig: En virksom del av leseopplæringen er ikke en fullstendig leseopplæring.
Artikkelens «fonetikkforståelse» er noe upresist. Det aktuelle omfatter blant annet å oppfatte språklyder, koble dem til skrift og trekke dem sammen til ord. Å forklare disse ferdighetene konkret gjør det lettere å undersøke om eleven faktisk mestrer dem.
At tidlig avkoding forutsier senere leseforståelse, viser ikke alene effekten av en bestemt undervisningsmetode. Sammenhengen kan også avspeile språkferdigheter og læringsmiljø. Tiltaksstudier er derfor et viktig supplement. Omvendt trenger et tiltak som har dokumentert nytte, ikke først å bevises å forklare Englands nasjonale PISA-utvikling for å være verdt å bruke.
Mer kartlegging er ikke det samme som mer testpress
Det er nødvendig å skille mellom prøver som hjelper læreren å identifisere vansker, prøver som oppsummerer et læringsutbytte, og prøver som brukes til rangering eller kontroll. Det samme måleredskapet kan være nyttig til ett formål og utilstrekkelig til et annet. En kort kartlegging av avkoding sier for eksempel lite om hele kvaliteten på en skole.
Den relevante kjeden er: finne et konkret behov, velge egnet undervisning og undersøke om eleven får framgang. Mer informasjon er bare nyttig dersom skolen kan handle på den. Kartlegging kan ellers gi mer registreringsarbeid uten bedre hjelp. En enkelt prøve er heller ikke nødvendigvis tilstrekkelig for en individuell diagnose.
Et konkret eksempel utenfor PISA er EEFs evaluering av Embedding Formative Assessment. Forsøket i 140 engelske skoler fant bedre samlet GCSE-resultat på målet Attainment 8, men ikke dokumentert forbedring i engelsk eller matematikk hver for seg. Tiltaket var et utviklingsprogram for læreres vurderingspraksis, med faglige verksteder og kollegaobservasjon. Det var ikke et forsøk der elevene bare fikk flere tester.
Dette støtter oppmerksomhet om hvordan vurdering brukes, ikke et generelt krav om å øke antallet prøver. Formuleringen om forskere som er imot «gode tester» bør derfor presiseres: Er de uenige om målekvalitet, belastning eller bruk? Disse innvendingene må vurderes hver for seg.
England har dermed unngått den tydelige nedgangen i lesing mange land har hatt, men resultatene viser ingen sikker framgang fra disse tidligere målingene. En bedre plassering kan skyldes at andre går tilbake. I matematikk var resultatet i 2025 likt 2022 og lavere enn 2018; naturfag viste derimot signifikant framgang siden 2022. Fagene bør ikke samles i én fortelling om at alt stiger.
Stabilitet kan være et viktig resultat når omgivelsene blir vanskeligere. Men PISA alene forteller ikke hvordan England ville gjort det med en annen skolepolitikk. To lands ulike utvikling er heller ikke et kontrollert forsøk: De kan skille seg i elevsammensetning, ressurser, fravær, tiltak og tidligere trender. Utvalgskvalitet og sammenlignbarhet må vurderes i tillegg.
For å styrke forklaringen måtte man undersøke flere land eller reformforløp, utviklingen før tiltakene og hvilke elevkull som faktisk møtte endret undervisning. En modell som finner et avvik, har ikke dermed identifisert årsaken til avviket.
Wales: pass på hvilke reformer elevene faktisk møtte
Wales’ offisielle oppsummering viser signifikant nedgang i lesing fra 2015 og 2018, men ikke fra 2022 til 2025. Den langsiktige bekymringen er altså begrunnet, mens omtalen av den siste endringen må være mer forsiktig.
Hvis man sikter til den nye Curriculum for Wales, er tidsrekkefølgen avgjørende. Den ble innført gradvis fra 2022 og når Year 11 først i skoleåret 2026–2027. Det framgår av det walisiske parlamentets innføringsoversikt. Ut fra denne planen kan 2025-resultatene ikke behandles som utfallet for en generasjon som har fått hele skolegangen etter den nye læreplanen.
Hopfenbeck kan sikte til eldre endringer eller praksis som kom før den formelle reformen. Det er ikke avvist av denne tidslinjen. Men da må de konkrete endringene og elevenes eksponering dokumenteres. En generell motsetning mellom «kritisk tenkning» og «grunnleggende lesing» er for grov til å fungere som forklaringsvariabel.
Skjermbruk og foreldreengasjement: mulige mekanismer
Intervjuet er nyansert om lesing og skjerm: Mindre lesing kan svekke ferdighetene, mens svake ferdigheter kan gjøre at barnet unngår lesing. Dette er mulige tilbakevirkende prosesser, ikke konkurrerende forklaringer som nødvendigvis utelukker hverandre.
Forklaringen på mobilforbud illustrerer også et viktig metodepoeng: Skoler eller land med store problemer kan være mer tilbøyelige til å innføre tiltak. Da kan tiltaket være forbundet med svake resultater selv om det hjelper. At det er en mulig forklaring, beviser likevel ikke at et bestemt forbud virker; det krever en undersøkelse av selve tiltaket og gjennomføringen.
Utsagnet om at foreldreengasjement har «aller størst effekt» er vanskeligere å vurdere uten referanse og definisjon. Hva slags engasjement, sammenlignet med hva, og målt hvordan? Barnets vansker kan utløse mer hjelp, og familier med ulike ressurser har ulike muligheter til å hjelpe. Foreldres betydning kan være stor uten at intervjuet har dokumentert en rangering av årsaker.
Prioritering er nødvendig, men «topp eller bredde» blir for enkelt
Undervisningstid er begrenset. Mer tid til ett fag kan gå på bekostning av et annet, og slike valg må drøftes åpent. Men bedre grunnferdigheter er ikke bare et prosjekt for elever som skal til universitetet. De er også relevante for elever som trenger ekstra støtte, praktisk opplæring og større muligheter til deltakelse.
Det er derfor ingen nødvendig motsetning mellom tydelig undervisning og fellesskap. En må undersøke hvem som får utbytte av tiltakene, ikke bare gjennomsnittet. Anekdoten om egne barns overgang til engelsk skole illustrerer en erfaring; den gir ikke alene et representativt mål på nivå, undervisningstid eller kvalitet i de to systemene.
Før man konkluderer med at skolens brede oppdrag må reduseres, bør man også undersøke hva bedre bruk av eksisterende tid kan gi. PISA kan belyse enkelte konsekvenser av prioriteringene, men kan ikke fastsette den riktige vektingen av fag, trivsel, tilhørighet og andre verdier.
Hva står igjen som et godt begrunnet forslag?
En forsvarlig retning er å sikre at elever får systematisk opplæring i grunnferdigheter, at konkrete vansker oppdages, og at oppfølgingen undersøkes for om den virker. Dette bør begrunnes med relevant undervisningsforskning og tilpasses de aktuelle elevene. Det er noe mer presist enn å kopiere England eller å vedta «mer testing».
Hopfenbecks forslag står sterkest når PISA brukes til å stille spørsmål og tiltaksforskning brukes til å velge svar. Den samme grensen gjelder forslag om mer lærerautonomi eller mindre testing. Se også Killingbergtrøs kritikk av prøver og et snevert skolesyn: Å forsvare skolens bredde og å etterspørre kunnskap om elevenes læring kan høre sammen.
Gjennomgått 15. september 2026. Kildene er lenket ved de aktuelle påstandene. Dette er en analyse av intervjuets argumenter og publiserte resultater, ikke en ny årsaksanalyse av engelske eller walisiske elevdata.
Et rikt skoleliv og nyttige prøver kan høre sammen
Kritikken av å redusere skolen til prøveresultater er relevant. Men den begrunner ikke at bare bestemte arbeidsformer fungerer, eller at måling av ferdigheter innebærer å behandle barn som roboter.
Kort vurdering: Innlegget er sterkest som en appell for barns livskvalitet og skolens brede oppdrag. Det er langt svakere som analyse av læring og PISA. Verdier, årsakspåstander og kritikk av hvordan tall brukes, glir over i hverandre.
Teksten og den mest rimelige lesningen
Roald Killingbergtrøs debattinnlegg i Utdanningsnytt, publisert 15. september 2026, har den synlige tittelen «En prøve på et par timer skal altså være avgjørende for om vi har lykkes i livet». Analysen bygger på innholdet i den oversendte PDF-en, kontrollert mot originalen. Dette er forfatterens innlegg, ikke et offisielt standpunkt fra Utdanningsforbundet.
Den mest velvillige tolkningen er at han protesterer mot en offentlig debatt der barns verdi og skolens kvalitet reduseres til noen få mål. Kritikken bør tas alvorlig. Elever trenger et skoleliv som også rommer tilhørighet, lek, skapende virksomhet og praktiske erfaringer. Selv en presis ferdighetsmåling kan være utilstrekkelig som samlet vurdering av skolen.
Men når teksten i tillegg hevder hvilke aktiviteter som alene virker, og hva bestemte samfunnsendringer nødvendigvis fører til, fremmer den etterprøvbare påstander. Et rimelig verdistandpunkt fritar ikke slike påstander fra krav om dokumentasjon.
Tre spørsmål som bør holdes fra hverandre
En prøve kan være god til ett formål og dårlig til et annet
Spørsmål
Relevant kritikk
Hva må undersøkes?
Hva måler prøven?
Oppgavene kan dekke ferdigheten mangelfullt eller påvirkes av andre forhold.
Oppgaver, målemodell, motivasjon og sammenlignbarhet.
Hva sluttes fra resultatet?
En avgrenset skår kan bli en urimelig dom over hele skolen.
Om konklusjonen går lenger enn målegrunnlaget.
Hvordan brukes resultatet?
Rangering eller styringskrav kan skape uheldige insentiver.
Faktiske endringer i undervisning, belastning og elevutbytte.
Disse problemene kan opptre samtidig, men de er ikke identiske. Misbruk av en skår viser ikke automatisk at prøven måler dårlig. God målekvalitet viser heller ikke at enhver bruk av resultatet er forsvarlig.
PISA avgjør ikke om en elev har lykkes i livet
OECD beskriver PISA som en vurdering på systemnivå, ikke en prøve laget for å gi individuelle elever en samlet karakter. Formålet er ikke å avgjøre om et menneske har lykkes i livet. Dersom utsagnet leses som en beskrivelse av selve undersøkelsen, er det derfor misvisende.
Som retorisk overdrivelse om debatten kan det derimot peke på et reelt problem. Men da er det rimelig å spørre hvem som faktisk bruker resultatene slik, og hvilke konsekvenser det får. Innlegget viser ikke konkrete eksempler som underbygger den sterke formuleringen. Kritikken treffer sikrere hvis den avgrenses til bestemte tolkninger og beslutninger.
Det er heller ingen motsigelse i å mene at en ungdom har et godt liv og samtidig trenger bedre hjelp til lesing. Opplysninger om ferdigheter er verken et mål på menneskeverd eller en fullstendig beskrivelse av framtidsmuligheter.
«Uten kontekst med det virkelige liv» er for kategorisk
PISAs erklærte formål er å undersøke anvendelse av lese-, matematikk- og naturfaglige ferdigheter. Det er noe annet enn bare å telle hvor mange fakta eleven husker. Beskrivelsen av prøven som opptelling av kunnskap som er «puttet inn», gir derfor et ufullstendig bilde.
Dette betyr ikke at oppgavene automatisk er gode mål på ferdigheter utenfor prøven. En konstruert testsituasjon er ikke det samme som å løse en oppgave man har valgt selv og har god tid til. For å vurdere gyldigheten må vi undersøke hva oppgavene krever, hva som påvirker svarene, og hvordan resultatene henger sammen med andre relevante mål.
Den presise innvendingen er dermed at overføringen fra prøvesituasjon til andre sammenhenger trenger dokumentasjon. Det er en langt bedre problemstilling enn at en prøve av prinsipp er uten forbindelse med livet utenfor.
At barn er sammensatte, velger ikke undervisningsmetoden
Tekstens sterkeste metodepåstand er at bare lek, fantasi, eventyr, kreativitet og praktisk arbeid fungerer. Her mangler både avgrensning og dokumentasjon. Hva skal aktivitetene oppnå, for hvilke elever, på hvilket utviklingstrinn og sammenlignet med hva?
Metaforene om barn som jungler og kråkeslott uttrykker kompleksitet, men gir ingen logisk forbindelse til at én gruppe arbeidsformer er den eneste virksomme. Kompleksitet kan tvert imot være en grunn til å undersøke ulike behov og tilpasse støtten. Teksten protesterer mot ensretting, men den bokstavelige anbefalingen er selv svært generell.
Det finnes også et kunnskapsgrunnlag for systematisk undervisning: EEFs oversikt støtter eksplisitt og systematisk bokstav–lyd-opplæring som del av tidlig lesing. Det begrunner ikke ensformig undervisning hele dagen, men svekker den eksklusive påstanden om hva som kan virke.
Lek kan kombineres med forklaringer og veiledning. Praktisk arbeid kan inneholde målrettet øving. Skillet mellom lek og undervisning er derfor ikke så rent som teksten forutsetter. En elev kan være mentalt aktiv mens læreren forklarer, og utføre en praktisk aktivitet uten å forstå prinsippet bak. Vi må undersøke læringen, ikke slutte fra arbeidsformens navn.
Årsakene kan ikke etableres med parenteser
Innlegget kobler blant annet skoleskyss til dårligere fysisk form, digitalisering til tap av kreativitet og teoretisering til tap av praktiske ferdigheter. Dette kan formuleres som hypoteser, men er ikke nødvendige følger av aktivitetene.
Vi må vite hva aktiviteten erstatter. Skoleskyss kan erstatte en mulig gåtur, men også gjøre skolegang tilgjengelig over store avstander. Digital aktivitet kan fortrenge skapende arbeid eller selv være skapende. Teori kan gå på bekostning av praktisk øving, men også hjelpe eleven å forstå og gjennomføre den. Dette er mulige forløp, ikke påstander om hvor vanlige de er.
Det samme kravet gjelder bekymringen for kommersielle påvirkninger. For å forklare en nasjonal utvikling må en undersøke om eksponeringen har endret seg, hvilke elever som er berørt, og om endringen kan knyttes til utfallet. Sterkt negative beskrivelser av bransjer og kulturformer erstatter ikke slike undersøkelser.
At flere forhold hver for seg kan være belastende, viser heller ikke hvor mye hvert forhold bidrar til PISA-fallet. En opphopning av bekymringer blir ikke en statistisk dekomponering av årsaker.
Den holdbare kritikken gjelder også god testing
En god prøve kan brukes på en dårlig måte. Hvis skoler belønnes for et snevert mål, kan undervisningen bli innrettet mot akkurat dette målet. Hvis resultatene tolkes uten hensyn til elevgrunnlag og usikkerhet, kan vurderingene bli urettferdige. Dette er relevante risikoer som må undersøkes; innlegget dokumenterer ikke omfanget eller virkningen av dem.
Den motsatte risikoen må også tas med: Hvis skolen mangler gode opplysninger om hva eleven mestrer, kan behov bli oversett. Lærerens observasjoner, samtaler og elevens arbeid er viktige kilder. En egnet prøve kan tilføre informasjon. Ingen av kildene trenger å behandles som ufeilbarlig.
Et sobert standpunkt er derfor å kreve et klart formål for hver prøve, rimelig belastning, forsvarlig tolkning og faktisk oppfølging. Et generelt forsvar for prøver er like utilstrekkelig som et generelt angrep.
Hva bør vi ta med oss?
Skolens oppdrag kan ikke reduseres til det PISA måler. Det er en viktig påminnelse, og det bør få konsekvenser for hvordan resultater omtales og brukes. Men denne begrensningen viser ikke at ferdighetene er uviktige, at prøver gjør barn passive, eller at bare bestemte arbeidsformer gir læring.
En bedre formulering av innleggets anliggende er at barn skal ha et rikt skoleliv, samtidig som skolen må undersøke om den gir dem god opplæring. Vurdering bør brukes til å forstå behov og forbedre undervisning. Det krever at vi undersøker både hva prøven forteller og hva den lar stå ubesvart.
Gjennomgått 15. september 2026. Analysen gjelder Killingbergtrøs publiserte innlegg. OECDs formålsbeskrivelse brukes til å kontrollere omtalen av PISA, ikke som et uavhengig bevis på at enhver oppgave eller bruk av resultatene er gyldig.
Ulf Andersen etterlyser en veloverveid reaksjon på PISA-fallet. Det er en fornuftig oppfordring. Men påstandene om statistisk signifikans, hastige svar og «47 prosent» trenger vesentlige presiseringer.
Kort vurdering: Andersen har rett i at målemetode, prøvesituasjon og internasjonale utviklingstrekk må undersøkes før man velger skolepolitikk. Han går for langt når han omtaler de norske resultatene samlet som ikke signifikante og fremstiller samvariasjon mellom land som en påvist forklaring på nær halvparten av fallet.
Et innlegg med en rimelig hovedkonklusjon
Dette er en analyse av Ulf Andersens LinkedIn-innlegg, ikke av et offisielt standpunkt fra NAV. Andersen er statistikksjef i NAV, men argumentene må vurderes etter dokumentasjonen, uavhengig av avsenderens stilling.
Innlegget avviser ikke at utviklingen er alvorlig. Det advarer mot å hoppe fra lavere prøveresultater til å forkaste læreplaner eller vedta raske tiltak. Det skillet er viktig: PISA kan vise et problem uten å identifisere verken årsaken eller løsningen. Samtidig trenger argumenter som demper bekymringen like grundig kildekontroll som argumenter som skjerper den.
De fire forbeholdene
Hva argumentene gir grunnlag for
Forbehold
Vår vurdering
Avgjørende presisering
Norske resultater er ikke signifikante.
For bredt formulert og misvisende.
Fag, tidsrom og hvilken forskjell som testes må oppgis.
Endret prøve kan påvirke trenden.
Et relevant kontrollspørsmål.
Sammenfall i tid tallfester ikke en metodeeffekt.
Flere klikker gjennom; dette forklarer 47 prosent.
Indikatoren er relevant, men tolkningen går for langt.
Andel svar er ikke andel elever. Forklart variasjon er ikke en årsaksandel.
Nedgangen skjer også utenfor Norge.
Et viktig korrektiv.
Felles retning betyr verken samme størrelse eller samme årsak.
Signifikans gjelder en bestemt sammenligning, ikke et lands resultater i sin alminnelighet. Påstanden må derfor presiseres: Gjelder den Norge mot OECD, endringen siden 2022, endringen siden 2015, ett fag eller avstanden mellom elevgrupper?
I den norske rapporten er signifikante endringer markert med fet skrift. Tabellene 11–13 gir følgende bilde:
Norge: endring i PISA-poeng og rapportens signifikansvurdering
OECDs landnotat om Norge beskriver også lavere resultater i lesing og matematikk siden 2022, mens naturfag er omtrent uendret. Den generelle formuleringen i innlegget gir derfor et uriktig inntrykk. Den oppgitte oversettelsen må knyttes til en konkret kilde og sammenligning før den kan brukes som oppsummering av Norges utvikling.
En ikke signifikant endring er heller ikke dokumentasjon på at den reelle endringen er null. Den betyr at den aktuelle analysen ikke skiller endringen tilstrekkelig sikkert fra null ved den valgte terskelen og under modellens forutsetninger. Omvendt viser en signifikant nedgang verken hva som forårsaket den eller hvilket tiltak som vil hjelpe.
Utvalgsforbeholdet er et annet spørsmål. OECDs merknad om Norge gjelder også mulige skjevheter når utvalgsstandarder ikke er oppfylt. Systematisk skjevhet forsvinner ikke med en liten standardfeil eller et signifikant resultat. Høy eksklusjon kan trekke det rapporterte nivået opp hvis svake elever er underrepresentert; virkningen på en trend avhenger også av hvem som ble ekskludert tidligere. Dette er grunn til varsomhet, men ikke en generell frifinnelse av utviklingen.
2. Metodeendringer kan bety noe – men hvor mye?
Andersens metodiske spørsmål er legitimt. Hvis prøveformat, oppgaver eller navigasjon endres, må en undersøke om samme kompetanse gir samme forventede skår. Et brudd som opptrer samtidig med en prøveendring, er et spor å undersøke. Det er ikke i seg selv en beregning av hvor stor del av bruddet som er teknisk.
Samtidig ligger både 2015 og 2025 innenfor perioden med datamaskinbasert PISA i Norge. Hele fallet mellom disse årene kan derfor ikke uten videre tilskrives selve overgangen fra papir til PC. Senere endringer kan fortsatt ha betydning, men da må de undersøkes konkret. Det er også nødvendig å skille mellom virkningen av å lese på skjerm i prøven og virkningen av digitalisering på ferdighetene elevene har med seg inn i prøven.
At nye oppgaver innføres, betyr heller ikke automatisk at lavere skår skyldes vanskeligere oppgaver. I en koblet måleskala skal oppgavenes vanskelighetsgrad tas hensyn til. Spørsmålet er hvor godt koblingen fungerer: Holder trenden på sammenlignbare oppgaver, og virker oppgavene likt over tid og mellom elevgrupper? Det trengs slik dokumentasjon for å tallfeste en metodeeffekt.
Et særlig relevant poeng finnes i OECDs vedlegg A1, noter på s. 320: Ny testplattform og mindre layoutendringer kan påvirke registrert tidsbruk, og tidsterskler fastsettes separat for hvert år. Metodeforbeholdet gjelder altså også indikatoren som brukes som belegg for redusert innsats.
3. Hastige svar er ikke det samme som elever som gir blaffen
Her må vi først vite hva prosentene teller. I OECDs tabell I.4 er Norges tall for 2025 12,2 prosent. Kolonnen gjelder hastige responser, gjennomsnittlig over leseoppgaver, ikke prosentandelen elever som klikker gjennom hele prøven.
Jeg har ikke fått kontrollert tallparet 6,2–12,1 i samme tabell og med samme oppgaveavgrensning som Andersen bruker. Forskjellen mellom 12,1 og 12,2 kan skyldes ulike oppgavesett eller beregninger. Det er derfor ikke grunnlag for å erklære hans tall feil utelukkende på dette grunnlaget. Men en eventuell andel responser kan ikke uten videre omtales som en andel elever.
Forskjellen er stor: Ti prosent hastige svar kan være konsentrert hos noen få elever eller fordelt på mange elever som ellers arbeider grundig. Det sier ikke at ti prosent av elevene avviser hele prøven. Definisjonen krever dessuten både svært kort tidsbruk og manglende full uttelling; hurtighet alene er ikke nok.
En rask feil kan skyldes lav innsats. Den kan også skyldes at eleven raskt oppdager at oppgaven er for vanskelig, misforstår eller gir opp etter tidligere nederlag. Dermed kan svak kompetanse gi mer gjetting, samtidig som lav innsats kan gi svakere resultater. Retningene kan virke sammen. Se gjennomgåelsen av «sjusk», blanke svar og oppgaver eleven ikke nådde for definisjonene og en grundigere drøfting.
47 prosent av variasjonen er ikke 47 prosent av fallet
Hvis den omtalte regresjonen har R² = 0,47, betyr det at modellen beskriver 47 prosent av variasjonen mellom landenes skårendringer i det analyserte utvalget. Det er noe annet enn å finne at 47 prosent av den gjennomsnittlige nedgangen er forårsaket av mindre innsats. Regresjonen er ikke reprodusert her; vurderingen gjelder slutningen som trekkes fra det oppgitte tallet.
Forskjellen kan illustreres enkelt: Tenk at alle land får et stort, like stort fall av én felles årsak. I tillegg varierer landene litt, og disse små forskjellene følger en annen variabel helt perfekt. Da kan denne variabelen ha R² = 1, altså beskrive all variasjon mellom land, uten å forklare det store fallet som alle deler.
I denne saken kommer også årsaksproblemet i tillegg. Kompetanse, motivasjon og oppgavevansker kan påvirke både hastige responser og skår. Manglende full uttelling inngår til og med i definisjonen av indikatoren. Den er derfor ikke et uavhengig mål på en ytre årsak. For å tallfeste hvor mye større innsats ville ha løftet resultatene, trengs et troverdig anslag på hvordan de samme elevene ville prestert med større innsats. Landkorrelasjonen gir ikke dette svaret.
4. En internasjonal nedgang er et viktig korrektiv
Andersen har rett i at samtidige fall i mange land svekker forklaringer som bare viser til én særnorsk reform. Felles samfunnsendringer og felles trekk ved målingen er relevante kandidater. Men mange land kan også ha lignende skoleproblemer, og en felles påvirkning kan slå ulikt ut avhengig av undervisning, støtteordninger og elevsammensetning.
Det er dessuten forskjell på samme retning og samme størrelse. I den norske rapportens tabeller er nedgangen siden 2015 60 poeng i lesing for Norge mot 32 for OECD-gjennomsnittet, og 50 mot 27 i matematikk. Her brukes OECD-serien i samme rapport; en sammenligning med et fast sett land over tid er en egen analyse. Tallene viser likevel hvorfor «vi følger OECD» er en ufullstendig beskrivelse. De dokumenterer ikke i seg selv en bestemt særnorsk årsak.
Et naturlig neste steg er å sammenholde PISA med andre ferdighetsmålinger og undersøke hvilke aldersgrupper, fag og elevgrupper som endrer seg. Slike sammenligninger må også ta hensyn til at prøvene måler forskjellige ting. De er bedre egnet til å belyse om problemet går utover PISA enn en enkelt trendfigur alene.
Bekymringen for videre utdanning og arbeid er rimelig
Spørsmålene om frafall, vitnemål og arbeid er gode oppfølgingsspørsmål. Men PISA-tallene alene gir ingen prognose for hvor mange som vil falle utenfor. Det avhenger også av senere opplæring, støtte, gjennomføringskrav og arbeidsmarked. Et nasjonalt gjennomsnitt bør heller ikke brukes som en dom over den enkelte ungdoms framtid.
Andersens avslutning er derfor sterkere enn enkelte av begrunnelsene: Vi bør ta utviklingen alvorlig og undersøke den grundig før vi binder oss til store forklaringer og løsninger. En mer presis formulering ville være: Nedgangen er statistisk tydelig i flere sentrale sammenligninger, men måleusikkerhet og ukjent årsaksfordeling begrenser hva vi kan slutte om skolepolitikken. Motivasjon og metode kan bidra; bidragene er ikke tallfestet av den omtalte landkorrelasjonen.
Det er fullt mulig å være tydelig om et dokumentert problem og samtidig åpen om årsaken. Grundighet bør bety at tiltak begrunnes og evalueres, ikke at man må forklare hele PISA-fallet før elever med påviste vansker får hjelp.
Gjennomgått 15. september 2026. Grunnlag: innlegget gjengitt av leseren og lenket ovenfor, den norske PISA-rapporten, OECDs landnotat og vedlegg A1. Ingen ny analyse av elevdata eller reproduksjon av Christensen-regresjonen er gjennomført. Tallparet 6,2–12,1 og kildegrunnlaget for den generelle signifikansformuleringen er ikke endelig avklart.
Utdanningsforbundet · Analyse av et skolepolitisk opprop
God grunn til bekymring – men hva støtter løsningen?
Forbundet vil møte PISA-fallet med et langsiktig skoleforlik, bedre rammer og en sterkere lærerprofesjon. Det er en forsvarlig politisk posisjon. Det er ikke dermed en dokumentert virkning av tiltakene.
Kort vurdering: Teksten står sterkest i beskrivelsen av problemet og i kravet om gjennomtenkt oppfølging. Den står svakere når den avviser hele kategorier av tiltak og fremstiller sine egne prioriteringer som svaret på PISA. Dataene viser et behov for handling, men avgjør verken tiltakspakken eller den politiske avtaleformen.
Hva er det egentlig vi vurderer?
Dette er en gjennomgang av uttalelsen som er oversendt og oppgitt å være fra Utdanningsforbundet. Original lenke og publiseringsdato er ikke oppgitt. Analysen gjelder denne teksten, ikke alle forbundets standpunkter eller en full evaluering av Fellesskoleutvalgets utredning. Offisielle kilder og en tiltaksevaluering er brukt som kontrollgrunnlag. Vurderingene nedenfor er våre slutninger, ikke konklusjoner hentet fra PISA-rapporten.
Argumentet har tre ledd: Elevenes resultater er bekymringsfulle; skolens rammer og samfunnsendringer er viktige forklaringer; derfor bør politikerne velge et bestemt sett løsninger. Det første leddet har et tydeligere datagrunnlag enn overgangen til det siste. En riktig problembeskrivelse kan begrunne at noe må gjøres, uten å vise nøyaktig hva.
Påstandene, vurdert hver for seg
Vår vurdering av hvor langt begrunnelsen rekker
Påstand
Vurdering
Hva mangler?
Resultatene gir grunn til bekymring.
Godt begrunnet for ferdighetene som måles.
Flere datakilder trengs for hele bildet av skolen.
Flere svake lesere kan gi mer frafall.
Rimelig risikobekymring, ikke en fastslått prognose.
Oppfølging over tid og kunnskap om senere støtte og utdanningsløp.
Et skoleforlik vil gi mer læring.
Mulig, men ikke dokumentert av PISA.
Presise tiltak, finansiering og troverdig evaluering.
Mer testing og nye reformer er ikke svaret.
For kategorisk hvis det gjelder alle typer.
Skille mellom formål, belastning og virkning.
Sterkere profesjon og bedre rammer er svaret.
Relevant retning, men for lite konkret som effektpåstand.
Hva endres i undervisningen, for hvem og til hvilken kostnad?
Kvalitet kan ikke vedtas gjennom detaljstyring.
Treffer en begrensning, men overdriver motsetningen.
Skille mellom politiske rammer og pedagogisk gjennomføring.
1. Bekymringen er saklig – «kritisk grense» må forklares
Udir oppgir at andelen under nivå 2 i lesing har økt fra 15 prosent i 2015 til 34 prosent i 2025. Lesegjennomsnittet har falt 60 poeng. Dette er vesentlig mer enn bare en dårligere plassering på en rangering. Udir understreker samtidig økt usikkerhet på grunn av eksklusjon. Kilde: Udirs oppsummering av PISA 2025.
Nivå 2 er en faglig definert referanse for kompetanse, ikke et skarpt skille mellom å kunne og ikke kunne lese. En elev like under grensen er ikke fundamentalt forskjellig fra en elev like over. Gruppen under grensen rommer dessuten svært ulike ferdighetsnivåer. Forbundets formulering er mer forsiktig enn å kalle elevene analfabeter, men «under nivå 2» ville vært mer presist enn en udefinert kritisk grense.
På skalaens opprinnelige referanse tilsvarer 60 poeng 0,60 standardavvik. Det er en annen enhet, ikke en nedjustering av alvoret. Dette er heller ikke automatisk Cohen’s d: Da må forskjellen standardiseres med relevant spredning i de to elevkullene. Ingen av størrelsene er et estimat på effekten av skolepolitikken.
2. Frafall og ulikhet: et varselsignal, ikke en beregnet framtid
Det er rimelig å bekymre seg for at svake leseferdigheter gjør videre skolegang vanskeligere. Men den ordinære PISA-sammenligningen følger ikke de samme norske elevene fram til fullført videregående. Den kan derfor ikke fortelle hvor mye frafallet vil øke, eller hvem som kommer til å falle fra.
Et eksempel på et mer egnet design er den kanadiske Youth in Transition Survey, som fulgte omkring 30 000 deltakere fra PISA 2000 videre gjennom utdanning og arbeidsliv. Nettopp oppfølgingen, ikke bare testresultatet ved 15 år, gjør slike spørsmål mulig å undersøke. Kilde: OECD, Pathways to Success. En norsk prognose krever dessuten vurdering av norske utdanningsordninger og senere tiltak.
Flere elever under en grense betyr heller ikke i seg selv at forskjellene mellom elevene har økt. Dersom alle skårer like mye lavere, kan flere havne under grensen uten at spredningen endres. Økt ulikhet må undersøkes med fordelingen av resultater og forskjeller mellom grupper. Forbundet har grunnlag for en risikobekymring, men teksten bør ikke leses som om den allerede har dokumentert framtidig frafall og sosial ulikhet.
3. Hva PISA ikke avgjør om årsakene
PISA sammenligner nye utvalg av 15-åringer mellom måleår. Den fordeler ikke skoler tilfeldig til mer penger, mer autonomi eller mindre rapportering. Endringer i resultater skjer samtidig med endringer i elevgrunnlag, fravær, testinnsats, undervisning og livet utenfor skolen. En samtidig utvikling er derfor ikke nok til å isolere årsaken.
Lærernes erfaringer med uro og konsentrasjon er viktige observasjoner. De kan peke på mekanismer og vise hvor tiltak er vanskelige å gjennomføre. Men en erfaringsbeskrivelse kan ikke alene anslå hvor mye hvert forhold har bidratt til det nasjonale fallet. Forholdene kan også påvirke hverandre: Vansker med å forstå undervisningen kan svekke motivasjonen, samtidig som svak motivasjon kan hemme læringen.
Det samme gjelder spørsmålet om ansvar. Samfunnsendringer kan gjøre oppgaven vanskeligere uten at lærerne har blitt dårligere. Samtidig kan undervisning og organisering fortsatt forbedres. Å skille mellom skyld og mulighet til å hjelpe er viktig: Skolen kan påvirke et problem uten å ha skapt det.
4. Fellesskoleutvalget foreslår også endringer og felles krav
Det offisielle sammendraget av NOU 2026: 10 støtter vektleggingen av kapasitet og langsiktighet. Men utvalget foreslår også læreplanendringer, styrking av lesing og matematikk, strengere kompetansekrav og regulert veiledning av nyutdannede. Det omtaler en ny ressursnorm og avveiningen mellom lokalt handlingsrom og felles løsninger. Kilde: Det offisielle sammendraget av Fellesskoleutvalgets utredning.
Utvalget er altså ikke et argument for at nasjonale krav eller endringer generelt er feil. Den rimelige lesningen av forbundets tekst er at den advarer mot stadige, dårlig forberedte omlegginger. Hvis «ikke nye reformer» derimot betyr at innhold og organisering skal stå urørt, blir henvisningen til utvalget mindre sammenhengende.
En utredning kombinerer kunnskap, vurderinger og prioriteringer. At den anbefaler et tiltak, er ikke i seg selv et effektbevis. Utvalgets vurdering av at samfunnsendringer forklarer utviklingen, må heller ikke forveksles med en PISA-analyse som har skilt ut og målt alle konkurrerende årsaker. Det siste følger ikke av sammendraget.
5. «Mer testing» er ikke én bestemt politikk
Her trenger teksten sin viktigste presisering. En nasjonal utvalgsundersøkelse, en prøve brukt til rangering, en kartlegging av konkrete lesevansker og en kort forståelsessjekk i timen er forskjellige aktiviteter. De har ulikt formål og kan ha svært ulik nytte og belastning. Kritikeren av flere kontrollprøver trenger ikke være motstander av underveisvurdering.
En prøve gir ikke automatisk bedre læring. Men informasjon om hva eleven misforstår, kan brukes til å endre undervisningen og gi målrettet støtte. Å avvise «testing» som kategori blir derfor like upresist som å hevde at flere prøver alltid er løsningen.
Det finnes også tiltaksforskning som er mer relevant enn PISA for dette spørsmålet. I EEFs evaluering av Embedding Formative Assessment deltok 140 engelske skoler. Opplegget kombinerte lærernes faglige samarbeid, kollegaobservasjon og underveisvurdering. Evalueringen fant en positiv virkning på et samlet GCSE-resultatmål, men ikke dokumentert forbedring i engelsk eller matematikk hver for seg. Kilde: EEFs prosjektevaluering.
Dette er ikke et løfte om bedre norsk PISA-lesing. Det illustrerer at profesjonsutvikling og systematisk vurdering kan inngå i samme tiltak, og at effekten må undersøkes på de resultatene man faktisk ønsker å forbedre.
6. Profesjon, handlingsrom og penger må bli konkrete tiltak
Forbundets sterkeste positive argument er at lærere må ha mulighet til å utføre arbeidet godt. Men «styrke lærerprofesjonen» kan bety faglig veiledning, bedre rekruttering, mer planleggingstid, mindre rapportering eller større individuell metodefrihet. Dette er forskjellige tiltak. Støtte til ett av dem dokumenterer ikke automatisk virkningen av de andre.
Det finnes en plausibel mekanisme: Færre oppgaver utenfor undervisningen kan frigjøre tid til å oppdage og følge opp lesevansker. Det er en hypotese som kan undersøkes. Da må vi måle om tid faktisk blir frigjort, hvordan den brukes, hvilke elever som får mer hjelp, og om hjelpen virker. Mer handlingsrom uten tid, kompetanse eller oppfølging kan bli et løfte med lite innhold.
Det samme gjelder økonomi. PISA kan ikke fastsette det riktige norske skolebudsjettet. Et høyt utgiftsnivå mellom land beviser ikke at ekstra, målrettede midler er unyttige. Et fall i skår beviser heller ikke at generell budsjettvekst vil snu utviklingen. Spørsmålet er hva den neste bevilgningen finansierer, hvilke behov den møter, og hva man gir avkall på.
At forbundet representerer lærerne, gjør prioriteringene forståelige, men verken riktige eller gale. Bedre arbeidsvilkår kan ha egenverdi og være viktig for elevene. Påstanden om økt læring må likevel prøves selvstendig. Den samme bevisbyrden bør gjelde politikere som foreslår mer styring.
7. Tillit og ansvar er ikke motsetninger
Politikere kan ikke vedta at en elev skal forstå en tekst. De kan derimot bestemme finansiering, rettigheter, kompetansekrav og mål. Lærere må gjøre faglige vurderinger innenfor disse rammene. Det relevante spørsmålet er hvilket beslutningsnivå som er egnet for hvilken oppgave, ikke om enten profesjonen eller politikerne skal bestemme alt.
Tillit bør gi rom for begrunnede tilpasninger og åpen drøfting av problemer. Den bør ikke bety at praksis er fritatt fra vurdering. Omvendt bør evaluering gi nyttig informasjon, ikke bare nye dokumentasjonsoppgaver. Et bredt kunnskapssyn kan inkludere både målbare ferdigheter, elevsamtaler og observasjoner av undervisningen.
Det er heller ingen nødvendig motsetning mellom danning og lesing. Å kunne forstå krevende tekster er relevant også for kritisk tenkning og demokratisk deltakelse. PISA dekker ikke hele skolens oppdrag; det gjør ikke ferdighetene som måles, uviktige.
8. Et skoleforlik er en ramme, ikke en behandling
En bred avtale kan gi mer forutsigbar finansiering og tid til gjennomføring. Men enighet mellom partier er ikke i seg selv en pedagogisk virkemekanisme. Et forlik kan også bevare tiltak som ikke virker, dersom kompromisset blir viktigere enn resultatene. Verdien ligger derfor i innholdet, gjennomføringen og muligheten til å korrigere kursen.
«Ikke kortsiktige tiltak» bør bety nei til dårlig gjennomtenkte hastetiltak, ikke at elever med lesevansker skal vente på et langsiktig forlik. Rask hjelp og langsiktig kapasitetsbygging kan inngå i samme politikk. Tilsvarende trenger ikke et langvarig tiltak å være godt bare fordi det varer lenge.
Vårt forslag til kvalitetskrav er at avtalen beskriver konkrete elevbehov, tiltak og finansiering; gir tid og støtte til gjennomføring; og avtaler på forhånd hvordan virkning, kostnad og uønskede følger skal vurderes. Resultatene bør omfatte både læring, fordeling, skolemiljø og belastning på ansatte.
Der det er praktisk og etisk forsvarlig, kan trinnvis innføring med tilfeldig tildeling gi et bedre sammenligningsgrunnlag. Ellers må evalueringen begrunne hvorfor sammenligningsskolene gir et troverdig bilde av utviklingen uten tiltaket. En enkel før–etter-måling eller neste PISA-runde alene er ikke tilstrekkelig: Andre forhold kan ha endret seg samtidig.
Samlet vurdering
Utdanningsforbundet har et godt poeng når det etterlyser en gjennomtenkt og langsiktig respons, og når det minner om at forbedring må gjennomføres av mennesker med tid og kompetanse. Uttalelsen er dessuten uttrykkelig klar over at PISA ikke beskriver hele skolen.
Det svake punktet er spranget fra denne problembeskrivelsen til at én politisk retning er svaret, mens andre kategorier av tiltak avvises. PISA kan verken bevise at mindre styring er løsningen, eller at mer styring er det. Fellesskoleutvalget gir et bredere vurderingsgrunnlag, men erstatter ikke kunnskap om virkningene av hvert tiltak.
Den mest holdbare konklusjonen er derfor: Ja til å ta ferdighetsutviklingen alvorlig og sikre gjennomførbare rammer. Men krev at et skoleforlik konkretiserer hva som skal bli annerledes for elevene, hvorfor det forventes å virke, og hvordan vi skal finne ut om det gjør det.
Gjennomgått 14. september 2026. Grunnlag: den oversendte uttalelsen, Udirs resultatsammendrag, Fellesskoleutvalgets offisielle sammendrag, OECDs beskrivelse av den kanadiske oppfølgingsstudien og EEFs tiltaksevaluering. Lenker står ved de relevante avsnittene. Ingen ny analyse av PISAs elevdata er gjennomført her.
Hva kan internasjonale data faktisk si om to tiltalende forklaringer: at digitale læremidler påvirker PISA-resultater, og at mindre bruk av fysiske penger påvirker matematikk?
Kort konklusjon
Den strenge hypotesen om at mer digitalisering i skolen har forbedret PISA-resultatene kan ikke testes med en sammenlignbar, lang land–år-serie. PISA 2022 viser i stedet et ikke-lineært mønster på elevnivå: moderat digital læringsbruk er positivt assosiert med matematikkprestasjoner, mens mer enn omtrent én time daglig er negativt assosiert. Dette er ikke et kausalt estimat.
Kontanthypotesen lar seg heller ikke teste slik den er formulert. Kontantuttak per innbygger er en grov nasjonal proxy, ikke barns erfaring med mynter og sedler. Den avgrensede endringstesten fra 2015 til 2022 finner små og svært usikre sammenhenger. En mer relevant historisk kohorttest, der uttak i 2005–2009 sammenlignes med PISA 2015, gir heller ikke et matematikkspesifikt mønster: r = 0,17 for matematikk og r = 0,32 for lesing.
Hva måles – og hva måles ikke?
Tema
Indikator
Viktig begrensning
Digitalisering
OECDs digitale indikatorer og publiserte tabeller, særlig 2018 og 2022
ICT-modulen er valgfri og gir ingen lang, harmonisert landserie.
Kontantbruk
Kontantuttak per innbygger fra BIS, 2005–2009 og 2012–2024
Uttak er ikke betaling, og langt fra direkte mål på barns erfaring.
Kontantandel ved betaling
ECB SPACE, euroområdet
Kort tidsserie og betydelig pandemipåvirkning i 2022.
For PISA 2015-kullet må en god kontantindikator dekke omtrent 2005–2010, da elevene var fem til ti år. Den historiske BIS-tabellen gir delvis dekning av 2005–2009; den moderne maskinlesbare serien begynner først i 2012. Ingen av dem måler imidlertid barns kontantbruk direkte.
Digitalisering: et terskelmønster, ikke en enkel dose-respons
I PISA 2022 skåret elever som rapporterte inntil én time daglig digital læringsbruk på skolen 24 poeng høyere i matematikk enn elever som rapporterte ingen slik bruk. Etter justering for elevers og skolers sosioøkonomiske profil var forskjellen 14 poeng. OECD rapporterer at sammenhengen blir negativ ved mer enn én time.
Dette er forenlig med at moderat bruk kan inngå i godt organiserte læringsforløp, mens mye bruk kan fortrenge andre arbeidsformer. Det er ikke belegg for å si at nettopp bruken har skapt forskjellen. Elev- og skolegrupper kan samtidig skille seg i faglig nivå, lærerkvalitet, organisering, motivasjon og familiebakgrunn. Justering for sosioøkonomisk bakgrunn reduserer, men fjerner ikke, denne usikkerheten.
En meningsfull analyse av utvikling over tid ville krevd minst to sammenlignbare digitaliseringsmål per land, koblet til PISA-endringer og analysert med land- og årseffekter. Slike data foreligger ikke som en ren serie gjennom PISA-perioden. Det ville derfor være metodisk pynt å late som om en landvis årsaksanalyse allerede er gjort.
Kontanter: to nullfunn
Den pooled tverrsnittskorrelasjonen mellom kontantuttak og PISA-skår er positiv både for matematikk (r = 0,47, n = 27) og lesing (r = 0,59, n = 26). Dette sier lite om en mulig mekanisme for tallforståelse: sammenhengen er minst like sterk for lesing, og den kan skyldes velstand, betalingssystemer, landforskjeller eller datadekning.
Når vi ser på endring fra 2015 til 2022 innen de sju landene med nødvendige observasjoner, blir mønsteret borte: matematikk r = 0,10 (95 % KI −0,71 til 0,79) og lesing r = 0,16 (95 % KI −0,67 til 0,82). Når landet med størst absolutt endring i kontantuttak tas ut, er begge korrelasjonene fortsatt omtrent 0,20. Tallene gir ikke støtte til hypotesen, men utvalget er for lite til å utelukke moderate effekter.
Den historiske kohorttesten er bedre tilpasset mekanismen. For 15 land med både BIS-uttak i 2005–2009 og PISA 2015-skårer var gjennomsnittlige uttak per innbygger ikke signifikant forbundet med matematikk (r = 0,17; 95 % KI −0,37 til 0,63) eller lesing (r = 0,32; 95 % KI −0,23 til 0,71). Lesing har igjen et høyere punktestimat enn matematikk. Det taler mot den enkle ideen om en egen tall- eller tierstrukturmekanisme, selv om analysen fortsatt er tverrsnitt mellom land og bygger på en indirekte indikator.
Endring i kontantuttak og endring i PISA i det lille tilgjengelige panelet. Den røde linjen er en enkel lineær tilpasning; den etablerer ingen årsaksvirkning.
Hva en bedre analyse måtte gjøre
For landdata ville en mer troverdig modell måtte kontrollere for land- og årsforskjeller, mulig ikke-linearitet og forhold som BNP per innbygger, sosioøkonomisk bakgrunn, utdanningsnivå og bred samfunnsdigitalisering. Små landpaneler bør uansett tolkes deskriptivt.
For elevdata kreves alle plausible values, elevvekter og replikasjonsvekter etter OECDs analysemanual. En enkel regresjon på publiserte landgjennomsnitt kan ikke erstatte det. Den mest robuste konklusjonen er derfor metodisk: En enkel fortelling om «digitalisering opp, PISA ned» eller «kontanter opp, matematikk opp» overlever ikke kravene til måling, tidsforskyvning og spesifisitet.
Lesning av påstanden «Halvdelen af PISA-faldet er sjusk»
Hastige svar er et viktig spor – men ikke en årsaksforklaring
Innlegget peker på data som fortjener oppmerksomhet. OECD finner en tydelig økning i raske, feilaktige svar. Men den enkle land–land-regresjonen kan ikke avgjøre hvor mye av PISA-fallet som skyldes lavere innsats, eller om Danmark er feil målt.
Hva OECD faktisk har målt
Dette er ikke selvrapportering. I den datamaskinbaserte prøven logger PISA responstid for hvert spørsmål. For hvert oppgaveelement definerer OECD en nedre tidsgrense: første persentil av responstidene hos elever som fikk full uttelling, på tvers av alle deltakerland. Grensen settes aldri lavere enn ti sekunder. En respons under denne grensen som ikke får full uttelling, klassifiseres som «hasty» eller hastig. Også et raskt, blankt svar kan inngå; indikatoren teller ikke bare avgitte feilaktige svar.
Innleggets hovedidé er dermed reell: raske, feilaktige svar har økt. OECD rapporterer at andelen slike svar i leseoppgavene i snitt økte med mer enn fire prosentpoeng fra 2018 til 2025, til om lag 9 prosent. I matematikk fant OECD også en økning fra 2022 til 2025, med de største økningene i Serbia, Malta og Israel.
Men gjengivelsen av definisjonen er ikke helt presis. OECDs generelle indikator bruker ikke «99 av 100 som løste oppgaven i samme land»; den bruker raske, korrekte svar på den aktuelle oppgaven på tvers av PISA-landene, med en ti-sekunders nedre grense. Det finnes en beslektet, men separat, definisjon av «hastige lesere» i en kort leseferdighetstest.
Hva de danske tallene kan vise
Kjernen i vurderingen: En oppgitt R² på 0,47 betyr, dersom regresjonen er korrekt gjengitt, at en rett linje mellom to landendringer treffer 47 prosent av variasjonen i den valgte PISA-endringen i dette utvalget. Det betyr ikke at 47 prosent av elevenes faktiske resultatsfall er forårsaket av «sjusk».
En slik korrelasjon er interessant og fullt forenlig med at prøvesituasjon, oppmerksomhet og utholdenhet er en del av forklaringen. Men «ingen kontroller» er ikke en styrke når målet er årsak. Land som fikk svakere resultater, kan ha flere hastige feil fordi elevene har svakere forutsetninger for oppgavene, møter vanskeligere innhold eller har lavere utholdenhet. Det motsatte kan også skje: lavere innsats kan trekke resultatene ned. De to forklaringene kan opptre samtidig.
Det er også avgjørende hvilken prøve, hvilke land, hvilke år, hvilke vekter og hvilken håndtering av usikkerhet som ligger i regresjonen. Innlegget oppgir ikke nok til at R² = 0,47 og «tre PISA-poeng per prosentpoeng» kan etterprøves fullt ut. OECD publiserer de underliggende tabellene, men rapporterer ikke denne kausale dekomponeringen.
Påstand og faglig vurdering
Påstand
Hva dataene støtter
Hva de ikke kan avgjøre
«Hastige svar har økt»
Ja. OECD dokumenterer en tydelig økning, særlig i lesing fra 2018 til 2025.
Om hvert hastige svar er bevisst «sjusk». OECD peker selv på både oppmerksomhet, engasjement og svake grunnferdigheter som mulige tolkninger.
«Halvdelen af faldet er sjusk»
En bivariant sammenheng kan vise at endringene samvarierer mellom land.
En årsaksandel eller en kontrafaktisk PISA-skår uten hastige svar. R² er ikke et prosentregnskap over årsaker.
«Mobilforbud forklarer bare 0,8 %»
Enkle samvariasjoner kan sammenlignes deskriptivt hvis de bruker samme utvalg, tid og spesifikasjon.
At den med lavest R² er uten virkning, eller at forklaringskandidater kan rangeres som årsaker uten en felles modell.
«Danmark avviker, derfor er målingen feil»
Et stort avvik fra en enkel modell er et godt spørsmål å undersøke.
At målefeil er den nærliggende eller eneste forklaringen. Et residual kan like gjerne skyldes utvalgsusikkerhet, utelatte forhold, valg av fag eller en svak modell.
«Sjusk» er et for sterkt ord
Et feilaktig svar etter svært kort tid kan være et rent gjett. Det kan også være feilklikking, misforståelse, svak leseflyt eller at eleven gir opp før vedkommende får arbeidet med oppgaven. I den særskilte leseferdighetstesten skriver OECD uttrykkelig at raske elever med flere feil kan mangle grunnleggende leseferdigheter, oppmerksomhet eller engasjement. Tidsloggene er verdifulle nettopp fordi de avdekker at svaret ikke har den vanlige tidsinnsatsen; de forteller ikke alene hvorfor.
Det gjør heller ikke funnet uviktig. Evnen og viljen til å lese nøye, holde oppmerksomheten og bruke tid på krevende oppgaver er både en del av det PISA forsøker å måle i lesing og relevant utenfor prøven. Å avfeie hele utviklingen som en teknisk feil ville derfor være like forhastet som å omtale alle raske feil som bevisst juks.
Kan svakere kompetanse føre til mer gjetting?
Ja. En elev som raskt oppfatter at en oppgave ligger utenfor det eleven mestrer, kan gjette, hoppe over den eller gi opp. Da kan lavere kompetanse føre til flere hastige responser. De raske feilene blir delvis en følge av ferdighetsproblemet, ikke nødvendigvis et alternativ til det. Dette er en plausibel forklaring som må undersøkes, ikke en påvist forklaring på utviklingen.
Vi bør skille mellom minst tre muligheter: Eleven kunne løst oppgaven, men anstrenger seg ikke; eleven forsøker å orientere seg, men mangler kunnskapen som trengs; eller tidligere nederlag gjør at eleven gir opp stadig tidligere. I det siste tilfellet kan kompetanse, mestringsforventning og innsats påvirke hverandre over tid. Samme registrerte responstid kan derfor ha forskjellige forklaringer.
Innspillets «det kan like gjerne være motsatt» treffer et identifikasjonsproblem: Den enkle sammenhengen avgjør ikke årsaksretningen. Det betyr ikke at retningene dermed er like sannsynlige. En reell målefeil knyttet til lav innsats er fortsatt mulig, men vi kan ikke regne oss fram til elevenes kompetanse ved bare å fjerne det vi kaller «sjusk».
Indikatoren er heller ikke uavhengig av prøveresultatet: Manglende full uttelling inngår i selve definisjonen av en hastig respons. Når en indikator og et resultat bygger på de samme svarene, må samvariasjonen tolkes særlig varsomt. Dette gjør ikke enhver sammenheng uinteressant eller hele R² til en matematisk nødvendighet, men svekker grunnlaget for å behandle indikatoren som en ytre årsak til skåren.
Blanke svar og oppgaver eleven ikke kom fram til
Innspillet peker også på et viktig skille som OECD faktisk bruker i vedlegg A1. Det er ikke slik at alle manglende svar behandles som én type feil.
Registrert svarmønster og mulige tolkninger
Observasjon
Skillet i analysen
Hva vi ikke vet av dette alene
Rask respons uten full uttelling
Kan klassifiseres som hastig.
Om eleven mangler innsats, forståelse eller begge deler.
Blankt mellom besvarte oppgaver
Regnes som overhoppet. Kan også være hastig.
Om eleven leste, vurderte eller straks avviste oppgaven.
En ubesvart rekke på slutten
Behandles som ikke nådd og holdes utenfor disse beregningene.
Om eleven gikk tom for tid eller sluttet å forsøke.
Kilde: OECD, PISA 2025, vedlegg A1, s. 313 (PDF-side 315). Et overhoppet svar etterfulgt av besvarte oppgaver viser også at et blankt svar ikke generelt hindrer eleven i å komme videre. Det dokumenterer ikke fri navigasjon mellom alle testdeler.
Det er likevel for sterkt å oversette disse kodene direkte til «så oppgaven og tenkte at den var for vanskelig» eller «var for treg til å nå slutten». En oppgave kan vises uten å bli lest. En elev kan slutte å forsøke før tiden er ute. Loggdata om visning, tidsbruk og navigasjon kan gi mer informasjon enn svarmønsteret alene, men heller ikke en slik logg registrerer elevens begrunnelse direkte.
Dermed er det nyttig å skille mellom tre nivåer: hva som skjedde på skjermen, hvordan hendelsen kodes, og hvorfor eleven handlet slik. Det første kan observeres, det andre følger regler, og det tredje krever en begrunnet tolkning.
Å filtrere etter hvor langt eleven kom, løser ikke hele problemet
En analyse kan avgrenses etter framdrift dersom den aktuelle datafilen inneholder de nødvendige opplysningene. Men en må kontrollere hvilke oppgaver eleven faktisk fikk tildelt og kunne nå. Oppgavenummer alene er ikke et universelt mål på framdrift når testforløp varierer. Oppgaver som ikke inngikk i elevens prøve, må heller ikke telles som overhoppede.
Det er fornuftig å undersøke om sammenhengen består blant elever som hadde tid til å arbeide med de aktuelle oppgavene. Men de som kommer langt, kan samtidig skille seg fra andre i kompetanse, arbeidstempo, utholdenhet og tilbøyelighet til å gjette. Avgrensningen kan dermed endre elevgruppen man uttaler seg om og skape eller endre sammenhenger.
Et enkelt eksempel viser problemet: En elev arbeider grundig med få oppgaver og rekker ikke slutten. En annen klikker raskt gjennom alt. Et filter som beholder dem som «kom helt til slutten», kan velge bort den grundige eleven og beholde den som gjetter. Framdrift er derfor ikke det samme som innsats.
Det samme gjelder å fjerne raske feil og beregne resultatet på nytt. Dersom gjennomsnittet da øker, har man vist hva en endret utvelging og skåringsregel gjør med tallet. Man har ikke vist at de utelatte svarene ville vært riktige ved større innsats. Slike beregninger bør presenteres som følsomhetsanalyser, med tydelige antakelser.
Hva kunne skille forklaringene bedre?
En bedre undersøkelse ville kombinere tidligere eller uavhengige mål på ferdighet med oppgavenes vanskelighetsgrad, responstid, blanke svar og framdrift. Den bør undersøke om raske responser særlig oppstår når eleven møter oppgaver som er vanskelige i forhold til det eleven tidligere har mestret. Sammenligninger over tid må også kontrollere at indikatorene er beregnet på sammenlignbare oppgaver og elevutvalg.
Et forsøk som endrer elevenes motivasjon uten samtidig å undervise dem i stoffet, kan gi sterkere informasjon om virkningen av innsats. Men heller ikke et slikt forsøk vil uten videre vise hvor mye av et nasjonalt fall over flere år innsatsen forklarer. Det er forskjell på å påvise en mulig mekanisme og å tallfeste dens historiske bidrag.
Refleksjonen styrker altså kritikken av årsakspåstanden, samtidig som den minner om at PISA allerede skiller mellom flere typer manglende svar. God metodekritikk må ta hensyn til begge deler.
Danmark: legitimt kontrollspørsmål, ikke dom
Den danske restverdien kan være et nyttig utgangspunkt for kvalitetssikring. Før en trekker konklusjoner, må samme analyse gjentas med publiserte standardfeil, landvekter og alternative valg av land, fag og tidsintervall. Deretter bør man undersøke prøvedekning, eksklusjon, oversettelse, datainnsamling og om andre målinger viser samme endring.
Én residual etter en ujustert regresjon er imidlertid ingen test av sammenlignbarhet. OECD advarer selv mot å tolke landmønstre uten usikkerhet, og peker på at resultater i enkeltland har videre feilmarginer enn OECD-gjennomsnittet. Danmark kan godt være et interessant unntak; innlegget har ikke dokumentert at Danmark er feil målt.
Samlet vurdering
Den mest holdbare versjonen av påstanden er: Økningen i hastige responser kan gjenspeile svakere kompetanse, lavere innsats eller et samspill mellom dem. Sammenhengen med PISA-fallet avgjør verken årsaksretningen eller hvor stor del av fallet som ville forsvunnet med større innsats. Å ta blanke og ikke nådde oppgaver på alvor gjør analysen bedre, men gir ingen automatisk korreksjon til en «sann» skår.
OECD vurderer fallet i lesing som et robust funn, ikke sannsynligvis bare en måleartefakt, samtidig som de gir svekket fokus og oppmerksomhet en sentral rolle. De sier også eksplisitt at korrelasjoner mellom holdninger, innsats og resultater ikke er bevis på årsak. For Norge passer dette med den tidligere vurderingen på denne siden: testmotivasjon er relevant, men nedganger i TIMSS, PIRLS og nasjonale prøver gjør det lite sannsynlig at hele bildet skyldes PISA-situasjonen alene.
Oppdatert 15. september 2026 med refleksjoner om årsaksretning, blanke svar og utvalg etter framdrift. Dette er en metodisk drøfting; ingen ny beregning på elevdata er gjennomført.
Lesning av Simon Malkenes’ intervju, 12. september 2026
PISA viser et problem, men velger ikke skolepolitikken
Malkenes’ hovedanliggende er at norske skolemyndigheter har lett etter løsningene på feil sted: mer styring, testing og rapportering, mindre tillit til lærere og mindre rom for skolens brede samfunnsoppdrag. PISA kan underbygge at det finnes et alvorlig ferdighetsproblem. Det kan i langt mindre grad underbygge hans forklaring og konkrete styringsforslag.
Kort vurdering
Rimelig konklusjon: PISA er egnet til å dokumentere utvikling i elevers kompetanse og fordeling av resultater. Det er ikke en egnet årsaksstudie av kommunalisering, lærerautonomi, rapporteringskrav eller Kunnskapsløftet. Malkenes kan bruke PISA som et varsel og som utgangspunkt for spørsmål; han kan ikke bruke den alene som belegg for at nettopp OECD-inspirert styring har skapt fallet eller at hans reformpakke vil snu det.
Dette betyr ikke at forslagene er dårlige. Flere av dem kan være godt begrunnet av lærerprofesjonens erfaringer, skoleformålet, organisasjonsforskning og annen utdanningsforskning. Poenget er snevrere, men viktig: PISA-dataene bestemmer ikke mellom disse forklaringene.
Hva intervjuet faktisk foreslår
Malkenes argumenterer for at politikerne må lytte mer til lærerne og folk i skolen; lette administrative oppgaver og byråkratisk styring; la problemer løses nærmere klasserommet; ivareta den brede fellesskolen og elever som strever; og være langt mer varsom med reformer som gjør skolen til et redskap for måling, resultatstyring og økonomisk konkurranse. Han ber også om mer oppmerksomhet om lesing, fravær og elever med funksjonsvansker eller psykiske belastninger.
Det er en sammenhengende diagnose av styring og profesjonsrom, ikke bare et krav om høyere PISA-skår. Derfor bør den vurderes på to nivåer: Er diagnosen av årsakene troverdig? Og er forslagene ønskelige og virksomme, også for mål PISA ikke måler?
Hva PISA kan støtte – og ikke støtte
Forslag eller påstand
Hva PISA-dataene kan bidra med
Hva som må komme fra andre kilder
Gi lesing og grunnleggende ferdigheter høy prioritet
Sterkt grunnlag for problembeskrivelsen: Norge har hatt stort fall i lesing, og andelen under nivå 2 er høy.
Hvilke leseinnsatser som virker, når de bør settes inn og hvordan de skal organiseres. PISA undersøker femtenåringer, ikke tidlig leseopplæring eller tiltak over tid.
Reduser testing, rapportering og «målstyring»
PISA kan vise at svake resultater eksisterer samtidig med dagens styringsform.
Om styringsformen forårsaker resultatene, eller om mindre testing vil forbedre dem. Det krever data om arbeidsbruk, reformtidspunkt, lokale variasjoner og plausible sammenligningsgrupper.
Større lærerautonomi og lokal problemløsning
Spørreskjemaene kan beskrive læringsmiljø, opplevd støtte og enkelte trekk ved skolen.
Et kausalt anslag på virkningen av autonomi. Land- og elevsammenhenger kan ikke skille autonomi fra ressurser, kultur, seleksjon og styringskapasitet.
Mer støtte til elever som strever med fravær og belastninger
PISA dokumenterer store forskjeller og inneholder indikatorer på blant annet tilhørighet, trivsel og fravær.
Hvem som trenger hva, og om tiltakene bedrer oppmøte, helse eller læring. Registerdata, tjenestedata og forskning på tiltak er mer relevante.
Forsvar skolens demokratiske og sosiale oppdrag
Nesten ingenting direkte. PISA måler avgrensede faglige ferdigheter og noen holdninger.
Verdimessige valg og bredere mål som demokratisk dømmekraft, dannelse, praktiske ferdigheter og mening. De bør begrunnes selvstendig, ikke presses inn som PISA-bieffekter.
Den historiske påstanden trenger en annen metode
Malkenes knytter utviklingen til OECDs rolle i norsk skolepolitikk og til et skifte fra slutten av 1980-årene. Det er en historisk og institusjonell årsakspåstand. PISA begynte først i 2000 og måler gjentatte tverrsnitt av femtenåringer; den inneholder ikke et eksperiment der noen ellers like skoler fikk mindre rapportering, færre prøver eller en annen styringsmodell.
Den norske tidsserien taler også mot ordet «fortsatt» dersom det betyr et ubrutt fall siden 2003. Resultatene har beveget seg både opp og ned, med relativt sterke resultater i midten av 2010-årene, før den kraftige tilbakegangen etter 2015. Det er fullt mulig at lange institusjonelle endringer har betydning, men selve tidsserien isolerer ikke en slik mekanisme fra internasjonale trender, digitalisering, pandemien, fravær, endrede elevgrupper eller forhold utenfor skolen.
Eksklusjon: reelt forbehold, ikke forklaring på politikken
Malkenes har rett i at en eksklusjonsandel på 10,4 prosent i 2025 er et alvorlig forbehold. Når svake elever er overrepresentert blant dem som ikke deltar, kan det publiserte nivået bli for positivt. Men dette gjør først og fremst PISA til en forsiktig minimumsbeskrivelse av ferdighetsnivået. Det er ikke i seg selv belegg for en bestemt skolepolitisk forklaring eller reform.
Som vist i analysen på denne siden, bruker den norske rapporten et følsomhetseksempel der økningen i eksklusjon fra 2015 til 2025 bare forklarer rundt fire poeng av fallet dersom de ekskluderte antas å ha skåret hele 100 poeng lavere enn deltakerne. Usikkerheten er derfor viktig, men den opphever ikke den observerte tilbakegangen.
Hvor Malkenes har et viktig poeng
PISA er en lavt belønnet prøve av en begrenset del av skolens formål. Det ville være en feilslutning å behandle poengsummen som hele dommen over norsk skole – eller å gjøre alt som kan heve poengsummen til god utdanning. Dette gjelder særlig når PISA-fallet sameksisterer med spørsmål om fravær, utrygghet, psykisk belastning og en skolehverdag lærere opplever som tyngre.
Men dette er et argument for flere kunnskapskilder, ikke for å erstatte PISA med profesjonserfaring alene. Lærerstemmer, elevstemmer, administrasjonsdata, registerdata, klasseromsforskning og uavhengige evalueringer bør trekke i samme retning før man konkluderer om årsaker og store reformer.
Hva som ville prøvd forslagene skikkelig
En mer solid prøving av Malkenes’ styringsdiagnose måtte koble skole- og kommunedata over tid: lærernes arbeidsoppgaver, ledelses- og støttefunksjoner, nasjonale og lokale prøver, budsjett, bemanning, fravær, elevsammensetning og resultater i flere målinger. Reformer og kommuner kan deretter sammenlignes med passende før–etter-design, ikke bare med en nasjonal PISA-kurve.
For lesing bør tiltak testes gjennom gode lokale utprøvinger eller troverdige kvasi-eksperimenter, og måle både avkoding, leseforståelse, lesevaner og varighet. For styring og tillit bør man også måle lærernes tid, rekruttering, turnover og undervisningskvalitet. Da blir det mulig å oppdage om en ønskelig reform faktisk hjelper elevene, i stedet for å bruke PISA som dommer over et helt skolesyn.
Samlet vurdering
Malkenes’ mest overbevisende PISA-baserte poeng er at resultatene gir grunn til å ta lesing, ulikhet og elever som strever på alvor. Hans bredere påminnelse om at en skole ikke bare skal produsere målbare resultater, står dessuten på egne normative bein.
Det svakeste leddet er slutningen fra PISA-fallet til at OECD-skolen, byråkratisering eller manglende lærerautonomi er den avgjørende årsaken – og derfra til at en bestemt styringsreform vil løse problemet. Den slutningen kan være sann, men PISA-dataene kan ikke avgjøre den. Å lytte mer til lærere er et fornuftig demokratisk og profesjonelt prinsipp; som effekt på PISA-resultater er det foreløpig en hypotese som må undersøkes.
Kilder
Simon Malkenes i Dagsavisen, «Jeg ville lyttet til lærere og de som er i skolen», 12. september 2026 – intervjuet som analyseres.
En god innvending mot lesepanikk – ikke et bevis mot lesefallet
Kronikken «Kan fire av ti norske gutter virkelig ikke lese?» treffer en overtolkning av PISA. Men motivasjonsforskningen gir mindre støtte til hans alternative forklaring enn teksten kan gi inntrykk av.
Kort vurdering
Beaumont har rett i det viktigste korrektivet: Under nivå 2 betyr ikke at eleven ikke kan lese, og prestasjoner påvirkes av innsats. Han dokumenterer derimot ikke at motivasjon er den største feilkilden i Norge, hvor mye den forklarer av tilbakegangen, eller at PISA derfor er uegnet som mål på utviklingen i lesekompetanse.
Dette er ikke et valg mellom å stole blindt på PISA og å forkaste undersøkelsen. Det avgjørende er hvilke slutninger tallene tåler. Kronikken er sterkest som kritikk av bastante medieoversettelser, svakere som forklaring på det norske fallet og svært begrenset som begrunnelse for konkrete skoletiltak.
1. «Under nivå 2» er ikke en analfabetismegrense
Det norske resultatet som diskuteres, er et anslag på andelen gutter under en bestemt grense på PISAs leseskala. Det er ikke resultatet av en undersøkelse hvor fire av ti gutter har mislyktes med å lese Ole Brumm. Den norske rapporten oppgir 41 prosent under nivå 2 blant guttene. Kilde: Jensen mfl. (2026).
En grense for ønsket kompetansenivå er noe annet enn en grense mellom å kunne og ikke kunne lese. Gruppen under grensen er dessuten sammensatt. Å lese ord, forstå en kort beskjed, trekke slutninger fra en fortelling og vurdere troverdigheten til flere tekster er ulike oppgaver. En boktittel uten en definert oppgave og et vurderingskriterium er ingen presis målestokk.
Her trenger Beaumont faktisk ikke motivasjonshypotesen for å ha rett: Selv dersom alle elevene gjorde sitt ytterste, ville oversettelsen fra «under nivå 2» til «kan ikke lese» være for grov. Samtidig blir ikke en stor gruppe med svake resultater uproblematisk fordi den sterkeste medieformuleringen er feil.
2. En test trenger ikke være «ren» for å være informativ
Beaumont legger stor vekt på at leseferdighet ikke er den eneste faktoren bak en testskår. Det er en relevant innvending mot å behandle skåren som et uttømmende mål på elevens evner, men ikke tilstrekkelig til å avvise målingen. Validitet handler om hvor godt bestemte tolkninger og bruksområder kan begrunnes, ikke om at alle andre påvirkninger er borte.
Vi må skille mellom situasjonsbestemt manglende innsats og vansker med å opprettholde lesing. En elev som kan løse oppgaven, men klikker tilfeldig fordi prøven oppleves irrelevant, skaper et annet tolkningsproblem enn en elev som strever med sammenheng og forståelse i lengre tekster. I praksis kan ferdighet, interesse og utholdenhet påvirke hverandre.
Det ville derfor være like urimelig å kalle all lav innsats en lesevanske som å avskrive all sviktende utholdenhet som irrelevant for lesing. Det empiriske spørsmålet er hvor mye testviljen påvirker sammenligningene, og om påvirkningen har endret seg. Kronikken demonstrerer en mulig feilkilde, ikke størrelsen på den.
At en prøve ikke gir karakter eller individuell tilbakemelding, betyr heller ikke logisk at den er meningsløs for alle. Elever kan ønske å mestre oppgavene eller bidra til undersøkelsen. Påstanden om klønete oversettelser er på samme måte etterprøvbar: Man må undersøke konkrete oppgaver og språkversjoner. En generell karakteristikk av tekstene viser ikke at sammenligningen er ugyldig.
3. Hva betyr egentlig «32 prosent»?
Studien til Zamarro, Hitt og Méndez rapporterer at flere mål på innsats i test og spørreskjema samlet forklarer 32–38 prosent av variasjonen i testskårer mellom land. Det er et reelt forskningsfunn, men et annet utsagn enn at en tredjedel av Norges PISA-fall skyldes motivasjon. Kilde: Zamarro mfl. (2019).
Tre skiller er avgjørende. For det første handler resultatet om spredningen mellom land, ikke størrelsen på et bestemt lands skår. For det andre er statistisk forklart variasjon ikke automatisk en kausal fordeling mellom «ekte ferdighet» og «bare motivasjon»: Indikatorene kan også henge sammen med læringshistorie, ferdigheter og andre landforskjeller. For det tredje er en forskjell mellom land ikke en endring i Norge over tid.
Det er derfor ikke forsvarlig å trekke 32 prosent fra det norske poengfallet eller fra andelen under nivå 2. Tallet kan heller ikke omregnes direkte til Cohen’s d. En variansandel og en standardisert gjennomsnittsforskjell svarer på forskjellige spørsmål; vi har ikke et estimert norsk motivasjonstap å sette inn i en slik beregning.
Påstanden om Norges plassering i øverste fjerdedel for fall gjennom testen er ikke selvstendig kontrollert mot originaltabellen her. Selv om plasseringen stemmer, viser den ikke at slik svekkelse er blitt større siden forrige PISA-runde. En historisk rangering av utholdenhet er ikke dokumentasjon på en ny årsak til nedgang.
4. Belønningseksperimentet er sterkere – men har begrenset rekkevidde
Gneezy og kolleger undersøkte økonomiske insentiver ved to amerikanske og fire skoler i Shanghai. De amerikanske elevene forbedret prestasjonene, mens forskerne ikke fant tilsvarende forbedring i Shanghai. Dette er eksperimentell støtte for at insentiver kan påvirke testresultater, ikke bare en korrelasjon mellom selvrapportert motivasjon og skår. Kilde: Gneezy mfl. (2019).
Men forsøket gir ikke et representativt estimat for norske gutter i 2025. En effekt i bestemte skoler, med bestemte oppgaver og en bestemt belønning, kan ikke uten videre overføres til en nasjonal leseundersøkelse. Fravær av påvist effekt i Shanghai viser heller ikke at motivasjon aldri betyr noe der.
Studien støtter altså Beaumonts generelle advarsel om sammenlignbarhet. Den støtter ikke en tallfestet «korreksjon» av Norges resultater eller at hoveddelen av tilbakegangen forsvinner dersom norske elever anstrenger seg mer. Et norsk, representativt forsøk med tilfeldig tildelte insentiver ville gitt vesentlig bedre grunnlag for den slutningen.
5. PIAAC er ikke en oppfølging av PISA-elevene
Norges sterke voksenresultater er reelle. OECD oppgir 281 poeng i lesing for aldersgruppen 16–65 år og 288 for 16–24-åringene i den siste PIAAC-runden. Dataene ble samlet inn i 2022–2023. Kilde: OECDs PIAAC-landnotat for Norge.
Men alternativene «nordmenn blir bedre lesere som voksne» og «voksne er mer motiverte» er ikke uttømmende. Her sammenlignes forskjellige årskull, aldersgrupper, utvalg, oppgaver og måletidspunkter. Femtenåringene i PISA 2025 var for unge til å inngå i denne PIAAC-runden. Selv resultatet for unge voksne følger derfor ikke den aktuelle elevgruppen.
En høy voksenplassering kan sameksistere med svakere ferdigheter hos et nytt ungdomskull. Utdanning, arbeid og seleksjon kan dessuten spille inn. Rangeringer avhenger også av hvilke land som deltar. Vi kan ikke lese PIAAC som et eksperiment hvor de samme nordmennene har fått høyere motivasjon mens alt annet er holdt konstant. PIAAC-poeng kan heller ikke trekkes direkte fra PISA-poeng.
6. OECD undersøker allerede innsats og utholdenhet
I vedlegg A1 til PISA 2025 undersøker OECD blant annet hastige svar, rapportert innsats og prestasjoner gjennom testen. Analysene av oppgaverekkefølge og testtretthet gir ikke støtte til at generell tretthet under prøven spiller en vesentlig rolle i de observerte trendene. Samtidig behandles redusert engasjement som et relevant tolkningsspørsmål. Kilde: OECD (2026), vedlegg A1, særlig s. 313–318.
Dette avgjør ikke alle spørsmål om motivasjon, og OECDs egen analyse skal også vurderes kritisk. Men den er et viktig motargument mot å behandle utholdenhet som en oversett forklaring som allerede er bekreftet. Ulike indikatorer måler ulike sider ved innsats; én indikator alene kan ikke avgjøre saken.
Her møter kronikken analysen i fanen «Hastige svar»: At hurtige feil og lavere skår opptrer sammen, er et spor. Det er ikke i seg selv et mål på hvor mye lesekompetanse eleven ville vist med full innsats.
7. Tiktok, teoriprøver og forskjeller mellom land
Beaumont har et godt logisk poeng når han skiller landforskjeller fra norsk nedgang. En uendret motivasjonsforskjell mellom Norge og andre land forklarer ikke i seg selv at Norges resultat faller. Endret testvilje i Norge kan derimot bidra. Da må endringen påvises; den kan ikke utledes fra at testen generelt er kjedelig.
Hypotesen om at algoritmestyrte medier svekker konsentrasjonen, som igjen svekker testprestasjonene, er mulig. Men den inneholder flere årsaksledd. Kronikken viser ikke hvor store disse virkningene er, om de forklarer den norske trenden, eller hvordan redusert øving i lesing kan skilles fra lavere innsats på selve testdagen.
Teoriprøven er heller ikke en kontrollmåling av lesekompetansen til alle gutter. De som melder seg opp, kan være en selektert gruppe og kan forberede seg og prøve igjen. Hverdagsmestring er viktig informasjon, men motbeviser ikke automatisk vansker med mer krevende leseoppgaver. Og selv om en kinesisk deltakerregion ikke representerer hele Kina, følger det ikke at lave norske skårer uttrykker større selvstendighet. Det er en mulig fortelling om atferd, ikke et påvist funn.
8. Gir dette støtte til Beaumonts politiske forslag?
Til mer presis kommunikasjon og bedre måleundersøkelser: ja. Det er godt begrunnet å slutte å bruke «kan ikke lese» som synonym for under nivå 2, undersøke innsats systematisk og gjøre usikkerheten synlig.
Til mobilforbud, mindre testing eller strengere disiplin: ikke fra denne argumentasjonen alene. Selv om konsentrasjon er en del av problemet, må virkningen av hvert tiltak undersøkes særskilt. Et funn om lav innsats i en prøve uten karakter viser for eksempel ikke at færre prøver i skolen forbedrer lesing. Det kan heller ikke avgjøre om bestemte digitale læremidler hjelper eller skader.
Dette er samme prinsipielle skille som i Malkenes-fanen: En rimelig kritikk av PISA-bruk er ikke i seg selv evidens for en foretrukket skolepolitikk. Beaumont er ryddig når han sier at forslagene bør begrunnes uavhengig av tvilsomme tolkninger av PISA.
Hva ville avklart uenigheten?
Det mest nyttige ville være norske undersøkelser som kombinerer sammenlignbare leseoppgaver, tilfeldig tildelte tiltak for innsats, tidslogger og alternative leseprøver. Trendanalyser må håndtere utvalg, eksklusjon, oppgaveendringer og måleusikkerhet. Å bare fjerne elever med raske svar kan skape ny skjevhet, fordi svake ferdigheter også kan føre til at elever gir opp.
Man bør også sammenholde PISA med andre målinger. Beaumonts egen innrømmelse av at flere kilder peker mot svakere lesing, er viktig. Samsvar mellom undersøkelser styrker en problembeskrivelse, men er ikke uavhengig bevis for én årsak dersom flere prøver påvirkes av den samme motivasjonsendringen.
Samlet konklusjon: «Fire av ti gutter kan ikke lese» er en uholdbar forenkling. «Fallet er hovedsakelig manglende testvilje» er heller ikke dokumentert. Den mest holdbare posisjonen er å ta svake leseprestasjoner alvorlig, uten å gjøre skårene til en dom over elevene eller late som vi allerede kjenner årsaken.
Grunnlag og avgrensning. Analyse av Paul Beaumonts kronikk «Kan fire av ti norske gutter virkelig ikke lese?», Aftenposten, 13. september 2026, slik teksten er gjengitt av brukeren. Kildelenkene viser til rapporter og originalstudier, ikke til en egen reanalyse av elevdata. Det er ikke beregnet en norsk motivasjonskorrigert skår, effektstørrelse eller konfidensintervall. Vurderingen skiller mellom dokumenterte resultater og egne metodiske slutninger.
Harry Potter og PISA: tidsrekkefølgen passer dårlig
En litteraturkritikk av J.K. Rowling kan være interessant i seg selv. Som forklaring på det nyere fallet i leseferdighet møter den derimot et grunnleggende problem: Danmark var stabilt gjennom selve Harry Potter-bølgen.
Avgrensning: hva er det som vurderes?
Weekendavisens artikkel er abonnementslåst. Denne analysen vurderer derfor påstanden slik den fremgår av overskrift, omtale og skjermbildet som er delt med denne siden: at Harry Potter-bøkenes angivelig svake språklige eller litterære kvalitet kan være en forklaring på at barn leser dårligere, eller at serien derfor ikke bør brukes som lesefremmende løsning. Den tillegger ikke artikkelen flere påstander enn dette.
Det første utsagnet kan testes empirisk. Hvis bred eksponering for serien bidro vesentlig til et nasjonalt fall i lesekompetanse, må vi forvente at fallet begynner blant de årskullene som faktisk vokste opp med bøkene – eller at det gis en presis mekanisme som forklarer en svært lang forsinkelse.
Den enkleste testen: passer tidsrekkefølgen?
Kort svar: Nei, ikke for den enkle årsakshistorien. Danmark hadde PISA-skårer i lesing mellom 492 og 501 poeng helt frem til 2018. Det store fallet kom deretter: 489 i 2022 og 460 i 2025.
Harry Potter-bøkene kom ut fra 1997 til 2007. Filmserien fortsatte til 2011. De danske 15-åringene i PISA 2006–2018 var dermed nettopp de kohortene som hadde serien som barne- og ungdomsfenomen. Likevel var resultatene stabile – og høyest i 2018. Den danske PISA-rapporten beskriver selv perioden frem til 2018 som relativt stabil. Kilde: dansk PISA 2025-rapport, s. 19–22.
PISA-år
Omtrentlige fødselskull
Forhold til Harry Potter-bølgen
Danmark, lesing
2000
1984–85
For gamle til å ha vokst opp med serien da den startet.
497
2003
1987–88
Tidlig eksponering; de første bøkene var allerede store.
492
2006
1990–91
Kjernemålgruppe i seriens toppår.
494
2009
1993–94
Vokste opp mens hele bokserien ble publisert.
495
2012
1996–97
Barndom under bok- og filmbølgen.
496
2015
1999–2000
Vokste opp i bøkenes og de første filmenes storhetstid.
500
2018
2002–03
Hadde både de siste bøkene og filmene som oppvekstfenomen.
501
2022
2006–07
Født da bokserien ble avsluttet; filmene var fortsatt aktuelle.
489
2025
2009–10
Født etter bokserien; i hovedsak etter den opprinnelige lesebølgen.
460
Fødselskull er avrundet ut fra 15 år ved prøvetaking. Leseskårene er de danske tidsserietallene i PISA 2025-rapporten. Tabellen sier ikke hva hver enkelt elev leste; den tester bare om den foreslåtte tidsrekkefølgen er rimelig.
Hva tidslinjen faktisk undergraver
Den undergraver påstanden Harry Potter-bøkene førte til den senere PISA-nedgangen. En årsak som var størst i perioden 1997–2007, burde normalt ha gitt et lavere nivå eller en nedadgående utvikling blant 15-åringene i 2006, 2009, 2012 og 2015. Det ser vi ikke. Tvert imot følger høyere skårer og stor eksponering hverandre i denne meget grove tidsserien.
Dette beviser ikke at Harry Potter forbedret leseferdighetene. Landstidsserier kan ikke skille seriens virkning fra alle andre forhold som endret seg samtidig. Men den gjør den negative årsaksfortellingen mindre troverdig, fordi den viktigste forutsigelsen slår feil. For å redde hypotesen må man spesifisere en annen mekanisme: Hvorfor skulle en bokserie først svekke lesing ti–tjue år etter toppårene, og særlig for unge som ble født etter at bokserien var avsluttet?
Man kan formulere en like useriøs, men tidsmessig mer passende historie: at nedgangen i Harry Potter-lesing førte til PISA-fallet. Den er ikke bedre vitenskap. Den illustrerer bare poenget: At to kurver ser ut til å gå hver sin vei, eller sammen, er ikke en forklaring uten mål på faktisk lesing og en troverdig mekanisme.
«Dårlig litteratur» og «dårlig lesing» er to forskjellige spørsmål
Det er helt legitimt å mene at Rowling skriver klisjéfylt, forutsigbart eller språklig enklere enn annen litteratur. Det er en estetisk dom. Derfra til at bøkene gjør barn til svakere lesere, trengs flere ledd som må dokumenteres.
For det første må man vise fortrengning: at Harry Potter erstattet mer krevende lesing, ikke at bøkene fikk barn som ellers ikke leste, til å lese lange tekster. For det andre må man vise læringseffekt: at denne erstatningen faktisk svekket ordforråd, utholdenhet, slutningslesing eller kildevurdering. For det tredje må det passe med tidspunktet og være stort nok til å flytte et helt lands gjennomsnitt. Salgstall eller sterke meninger om stil kan ikke gjøre den jobben alene.
Det er også metodisk feil å la «litteratur jeg helst vil at barn skal lese» bli synonymt med «litteratur som utvikler leseforståelse». Mengde, motivasjon, språklig kompleksitet, samtale om teksten og progresjon mot andre tekster kan alle bety noe. Populærlitteratur kan være en inngang til lesing; den kan også være et dårlig endepunkt dersom eleven aldri møter mer krevende tekster. Begge påstander krever forskning, ikke bare kulturkritikk.
Danmarks videre fall taler dessuten mot en smal bokforklaring
Den danske tilbakegangen etter 2018 gjelder ikke bare lesing. Rapporten dokumenterer også fall i matematikk og naturfag, og den fremhever at en lignende nedgang finnes i mange land. Kilde: VIVE. Det beviser selvsagt ikke at forklaringen er den samme i alle fag, men det gjør en forklaring som bare handler om én bestemt fantasyserie mindre sannsynlig som hovedforklaring.
PISA 2025 viser dessuten en bred internasjonal nedgang i lesing. OECD beskriver et markert fall siden 2018 i et flertall av systemene med sammenlignbare data. Kilde: OECD, PISA 2025 Results, Volume I. En Danmark-spesifikk teori må da forklare både hva som var særskilt dansk, og hvorfor mange andre land gikk samme vei.
Hva ville vært en seriøs undersøkelse?
En relevant studie ville følge barn over tid og måle hva de faktisk leser, hvor mye de leser, hva Harry Potter eventuelt erstatter, og senere ferdigheter på uavhengige leseprøver. Den måtte ta høyde for at gode lesere oftere velger lange bøker i utgangspunktet, og for familieforhold, skole, språk hjemme og generell mediebruk. Man kunne også undersøke om Harry Potter fungerte som bro til annet lesestoff eller som en isolert leserutine.
Den globale lanseringen og toppsalget viser i alle fall at serien var et massivt fenomen før og rundt 2007; en amerikansk publisert tidslinje dokumenterer blant annet rekordsalg ved de to siste bokutgivelsene. Kilde: Scholastic. Det er ikke et mål på danske barns lesing, og siden er utgivers egen kommunikasjon – nettopp derfor brukes den her bare til å tidfeste fenomenet, ikke som belegg for lesefremmende effekt.
Samlet vurdering
Rimelig konklusjon: Det finnes ikke grunnlag her for å hevde at Harry Potter forklarer PISA-fallet. Den danske tidsrekkefølgen trekker snarere tydelig i motsatt retning: perioden med størst Harry Potter-eksponering sammenfaller med stabile danske leseresultater, mens fallet kommer senere. Dette frikjenner ikke serien som en hvilken som helst lesepedagogisk løsning, men det flytter bevisbyrden dit den hører hjemme: til data om faktisk lesing og dokumenterte læringsvirkninger.
Scenarioet gjelder bare 2025. For å justere utviklingen må vi også vite hvem som var utelatt i tidligere år.
02
Utvalg er ikke årsak
En høy eksklusjonsandel kan gi et skjevt bilde. Den viser ikke i seg selv at noen har jukset, eller hvorfor ferdighetene har falt.
03
Forskjell er ikke årsaksvirkning
Poeng, referanse-SD og d beskriver forskjeller. De kan ikke alene forklare hvorfor utviklingen har skjedd.
Åpent grunnlag
Kilder og metode
Førsteutgaven viser publiserte, avrundede landsgjennomsnitt. Den bygger ikke på en egen analyse av elevdata. Ingen konfidensintervaller eller signifikanstester er beregnet her.
Kurvene binder sammen måleår; de viser ikke observerte resultater i mellomårene. Forskjeller regnes fra de viste, avrundede tallene.
Hvilket standardavvik?
SD betyr standardavvik. I tidsseriegrafen bruker vi PISA-skalaens opprinnelige referanse: 100 poeng per standardavvik. Endringer deles på 100; et fall på 60 poeng blir dermed −0,60 referanse-SD.
I sammenligningstabellen er «SD 2025» derimot det publiserte standardavviket for det aktuelle landet og faget. Det må ikke forveksles med referanse-SD eller Cohen’s d.
I SD-grafen settes Norges gjennomsnitt i 2015 til null for hvert fag. Nivåforskjeller mellom fag i 2015 vises derfor bare i poengvisningen. Absolutte gjennomsnitt oppgis fortsatt i PISA-poeng.
Vi antar at gjennomsnittet for deltakerne også gjelder resten av den ikke-ekskluderte målgruppen, og at den ekskluderte gruppen ville skåret et valgt antall poeng lavere.
Andelen settes inn som desimaltall: 10,4 % = 0,104. Modellen tar ikke separat hensyn til fravær, øvrig frafall eller måleusikkerhet. Den sier ingenting om enkeltbarn.